Proxy
Proxy是一款非常实用的 AI代理工具,虽然它并不完美,但在处理日常琐事方面表现出色。它的核心优势在于简单易用、无需复杂设置,并且能够主动解决问题。对于忙碌的用户来说,Proxy 是一个值得信赖的数字助手,可以显著提高效率。
 Agensh
微软研究院近日正式开源了 Agensh,这是一个专为大型编码代理团队设计的去中心化多智能体(Multi-Agent)协作框架(harness)。Agensh 的核心创新在于移除了传统多代理系统中依赖的中央编排器(Orchestrator),允许每个工作节点(worker)自主认领子任务、共享发现并将代码合并至公共 Git 仓库。在 ProgramBench 基准测试中,该系统成功将代理规模从 1 个扩展至 1,024 个,显著提升了复杂任务的解决效率与通过率。
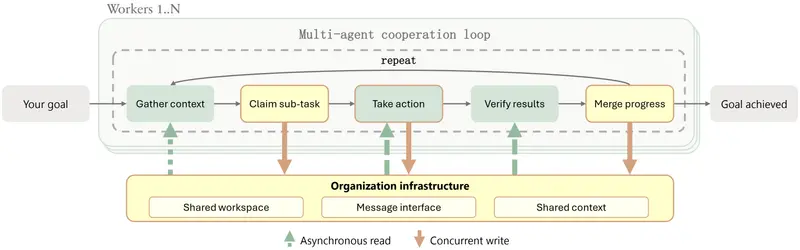
传统的“编排器-工作节点”设计(如 Claude Code Agent Teams 或 Copilot Fleet)往往受限于中央节点的规划与分配瓶颈。Agensh 通过将协调逻辑内置于提示词(Prompt)中,而非硬编码在运行时代码里,实现了真正的去中心化协作。每个 worker 并发且异步地执行以下 5 步循环:
该循环由三大基础服务支撑:Gitea 负责托管共享工作区(含分支、PR 与合并冲突管理);Mattermost 承载团队频道及用于紧急协调的直接消息;一个改编自 DeLM 的共享上下文板,用于存储类型化的笔记(如 OBSERVED、FACT、FAIL、CLAIM 和 PATCH_SUMMARY)。
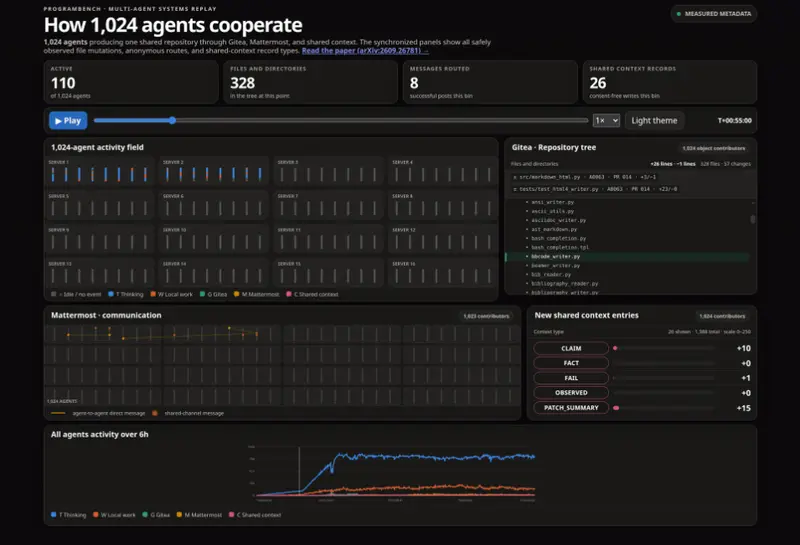
微软团队在 ProgramBench 上最具挑战性的 5 个任务(FFmpeg、gromacs、pandoc、PHP-src 和 ctags)上对 Agensh 进行了严格测试。代理需在 6 小时内离线重建程序行为,参考仓库规模从 2,767 个文件(pandoc)到 26,266 个文件(PHP-src)不等。
在使用高推理努力的 GPT-5.6-sol 模型时,5 项任务的平均最终测试通过率随代理数量增加而显著提升:
在单项任务上,扩展性优势更为明显。以 pandoc 为例,128 个代理在 30 分钟检查点即可达到 30% 的通过率,而 32 个和 8 个代理分别需要 60 分钟和 90 分钟。此外,在使用更新的 GPT-6.1-sol 模型时,pandoc 的通过率从 1 个代理的 56.19% 飙升至 32 个代理的 79.59%,实现了 41.64% 的相对增益。
随着团队规模的增长,Agensh 展现出令人瞩目的自组织行为,且这些角色均未被硬编码:
Agensh 作为一个“薄适配器”,构建在单代理 harness 之上(实验中使用 GitHub Copilot CLI),其设计允许通过简单修改接入其他框架(如 Claude Code)。
要运行 Agensh,需满足以下环境要求:
发布版本包含了单节点 Docker Compose 团队配置(默认 8 个 worker)和单代理基线。若需运行 1,024 个代理的规模,则需 16 个节点,每个节点承载 64 个代理,且每个 worker 的内存上限为 64 GiB。