HappyOyster
阿里巴巴正式推出了开放式世界模型产品 HappyOyster 1.0(快乐生蚝 1.0)。与传统的文生视频模型不同,HappyOyster 不仅仅是一个内容生成工具,更是一个能够实时构建、推演并响应用户互动的数字世界引擎。
 JST-2
Viggle正式推出JST-2,宣称它是世界上首个全栈物理原生世界基础模型。不同于多数世界模型在像素、视频空间学习外观,JST-2回归第一原理,整套模型架构在三维空间构建。模型可以在数秒内生成3D场景并持续扩展,使用统一架构创建自带动作能力的角色。
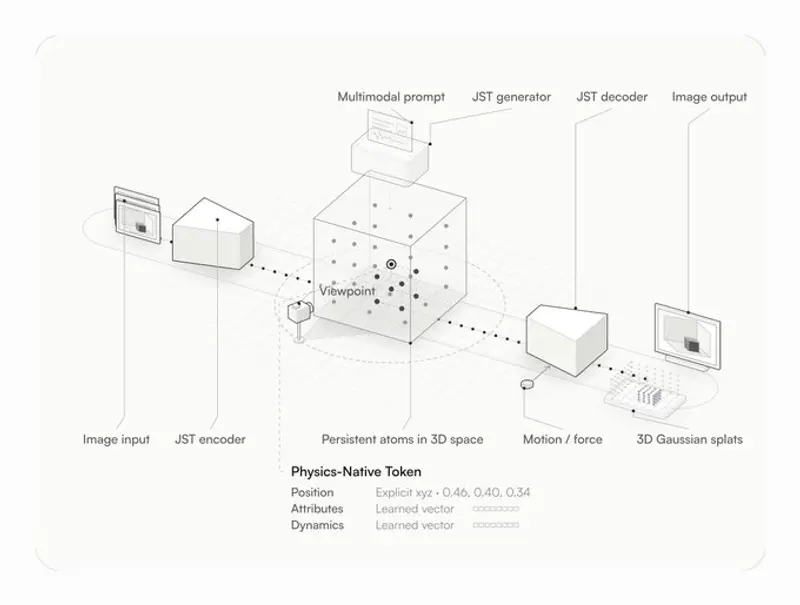
JST全称Joint Space-and-Time,它把整个世界建模为三维空间内持久存在的原子单元,每一个Physics-Native Token都带有显式xyz坐标,搭配可学习向量描述物体属性与运动规律。团队历时四年从零搭建整套技术栈,包含分词机制、模型架构、数据合成引擎、预训练以及后训练流程。
JST-2完成3D场景推理仅约1秒,单次推理成本低于0.01美元。模型最多支持64路输入视角作为空间上下文窗口,支持切换视角、持续拓展同一个三维世界。模型输出解码为3D高斯泼溅,在浏览器本地渲染,场景生成完成后,浏览视角不需要重复调用模型,只有新增内容才会触发推理。
它支持从稀疏真实世界观测重建完整三维环境,可用来基于真实场地搭建机器人仿真环境,具备自动驾驶、三维建图、建筑可视化等落地潜力。
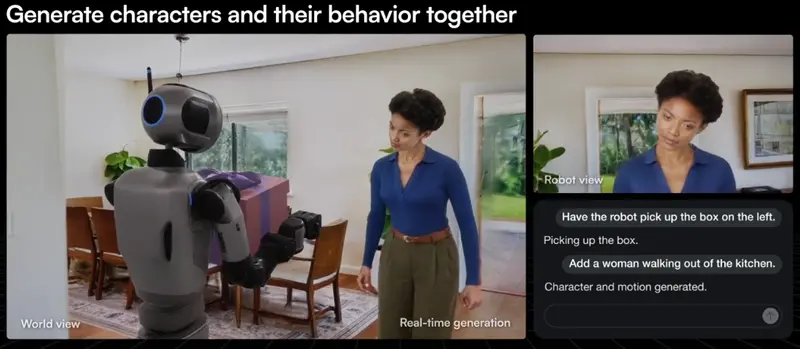
角色生成方面,JST-2可由文本或单张图像生成原生具备运动特性的3D角色,运动动态由模型直接学习获得,省去传统3D工作流的骨骼绑定、蒙皮工序。即便是局部遮挡的图像,也能补全完整人物模型,在盲测评估中,角色生成与动画表现优于Meshy 7.1、Tripo H3.1。
动作生成支持文本或者视频输入,输出全身3D动作。输入视频时,模型还原可见动作,同时推断被遮挡部位的运动。生成动作既可直接作用于JST原生角色,也兼容标准3D骨骼,盲测中文本驱动动作、视频驱动动作两项任务均领先竞品,手势、舞蹈细节与动作节奏表现力突出。
Viggle在2022年成立,先用两年时间研发JST-1,验证了这套物理原生架构,JST-1支撑的创作应用全球用户突破五千万。2024至2026年开发迭代出JST-2。
团队已经规划下一代JST-3。当前JST-2仅角色运动由学习动力学驱动,物体碰撞、交互依旧依靠规则物理模拟;JST-3目标将学习动力学拓展到物体之间的相互作用,用学习物理替代传统规则模拟,打造面向物理AI的体验引擎,让智能体能够在模拟世界里行动、观察结果、自主学习。后续版本还计划支持文本引导场景拓展、提升高斯泼溅细节,并且从视频中还原人物在场景内的移动轨迹。