GEOFlow
GEOFlow是一个面向 GEO / SEO 内容运营场景的开源内容生产系统。它把模型配置、素材管理、任务调度、草稿审核和前台发布串成一条完整链路,适合搭建自动化内容站点或内部内容运营后台。
TinyFish 的核心创新是剥离 AI 代理的检索 API 费用,把成本重心转移到网页文本带来的模型 Token 开销上,适合需要高频网页抓取、预算敏感的 Agent 项目。
 TinyFish
运行一个能够自主阅读网络的 AI 代理,通常需要支付两笔费用。第一笔是检索费用,即调用搜索或网页获取 API 的固定开销。第二笔是模型处理费用,检索返回的内容会作为输入 token 喂给大模型,随后的推理和生成还会产生额外的输出 token 成本。
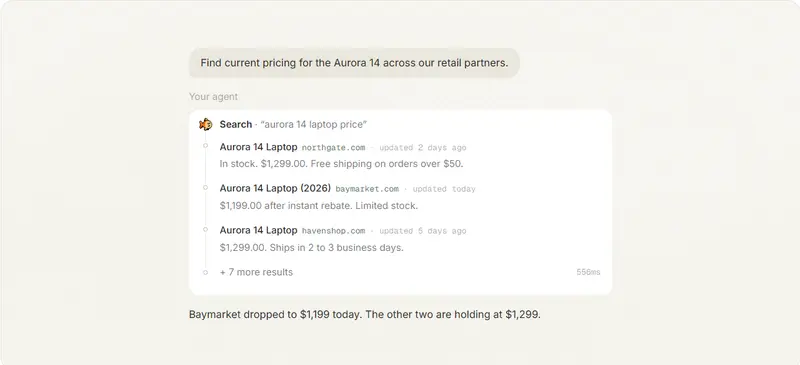
许多开发团队在预算分配时,往往精算模型本身的 token 价格,却低估了检索返回内容对整体 token 消耗的巨大驱动作用。TinyFish 作为一家的 AI 代理网络基础设施提供商,近期通过其免费策略和基准测试数据,揭示了这一隐性成本的结构。
不同的网页提取服务,返回的数据量差异极大。TinyFish 曾对 45 个 URL 进行过获取质量评估。以一篇约 4300 字符的 Daily Mail 文章为例,各提供商返回的数据量截然不同:
TinyFish Fetch 返回约 4737 字符,折合估计 1184 个 token。
Tavily Extract 返回约 46433 字符,折合 11608 个 token。
Exa Contents 返回约 65793 字符,折合 16448 个 token。
Firecrawl Scrape 返回约 171095 字符,折合高达 42774 个 token。
如果假设这些未经过滤的字符全部进入模型的上下文窗口,一个 42774 token 的页面就会占据 128K 上下文窗口的三分之一。三个这样的页面叠加,加上系统指令和对话历史,窗口将迅速耗尽。
更隐蔽的成本在于代理的循环机制。AI 代理在多轮交互中会重复发送完整的对话上下文。虽然模型缓存机制能降低重读相同内容的计费单价,但庞大的页面数据依然会持续占据宝贵的上下文空间,迫使系统更早地进行截断或摘要。
TinyFish 将其 Search 和 Fetch 服务在特定速率限制内设为免费。具体而言,Search 支持每分钟 30 次请求或每小时 500 次;Fetch 支持每分钟 150 个 URL 或每天 1000 个 URL。即使账户余额为零,这些基础功能仍可运行。
需要明确的是,免费仅指免除了 TinyFish 端的检索费用。下游大模型的推理成本依然存在。TinyFish 能够承担这种定价模式,主要基于三个底层支撑:
其一,共享基础设施。其浏览器队列、隐身系统和弹性扩展能力在 Search 作为独立产品推出前就已构建完毕,这大幅降低了单次检索的边际成本。
其二,专用模型。其网络原生 AI 模型专为搜索和实时站点交互设计,通过学习代理操作轨迹,减少了对昂贵通用大模型处理中间网络任务的依赖。
其三,定位差异。TinyFish 侧重于学习如何执行具体工作,而非维护庞大的全网索引。
在 Artificial Analysis 2026 年 9 月 28 日的快照中,测试环境固定了答案模型(GPT-5.6 Luna, medium),仅改变搜索提供商。这种设置下,各提供商之间的成本差异,直接反映了它们返回的有效载荷大小以及触发模型推理的次数。
数据显示,TinyFish 的总成本在展示的 12 个配置中最低,每 1000 个基准任务总成本为 9.30 美元(检索 0 美元 + 模型处理 9.30 美元)。相比之下,Exa 的总成本为 83.30 美元,Firecrawl 为 42.57 美元。
但这种成本优势伴随着明确的权衡。TinyFish 的 Search Index 得分为 71 分,在榜单中垫底,DeepSearchQA F1 得分为 67。同时,其单任务平均耗时达到 59.0 秒,是榜单中耗时第二长的配置。这一时间包含了模型处理与搜索的总和,而不仅仅是 API 的延迟。
对于开发者而言,选择检索服务不能仅看单次请求的标价。返回数据的质量、体积以及对整体工作流上下文窗口的占用,才是决定 AI 代理运行成本与效率的关键变量。