iphone-use
iphone-use 是一款开源工具,实现Computer Use能力,让AI Agent、浏览器可以识别并直接操作真实的iPhone设备。
tokentab是一款本地离线 AI 编码工具 Token 用量统计工具,tokentab 读取 Claude Code、Codex、Cursor、Gemini CLI 在本地磁盘留存的会话日志,统计令牌消耗与预估成本。支持按模型、项目、日期、会话工作类型做多维度拆分,全程本地运行,不需要账号、API 密钥,任何数据都不会离开本机。
 tokentab
 是一款完全在本地运行的命令行工具,用于读取 Claude Code、Codex、Gemini CLI 等 AI 编码助手留在磁盘上的会话日志,并据此统计令牌使用量与对应成本。该工具不依赖任何账户、API 密钥或网络连接,所有数据处理均在用户机器上完成,确保敏感会话信息不外泄。
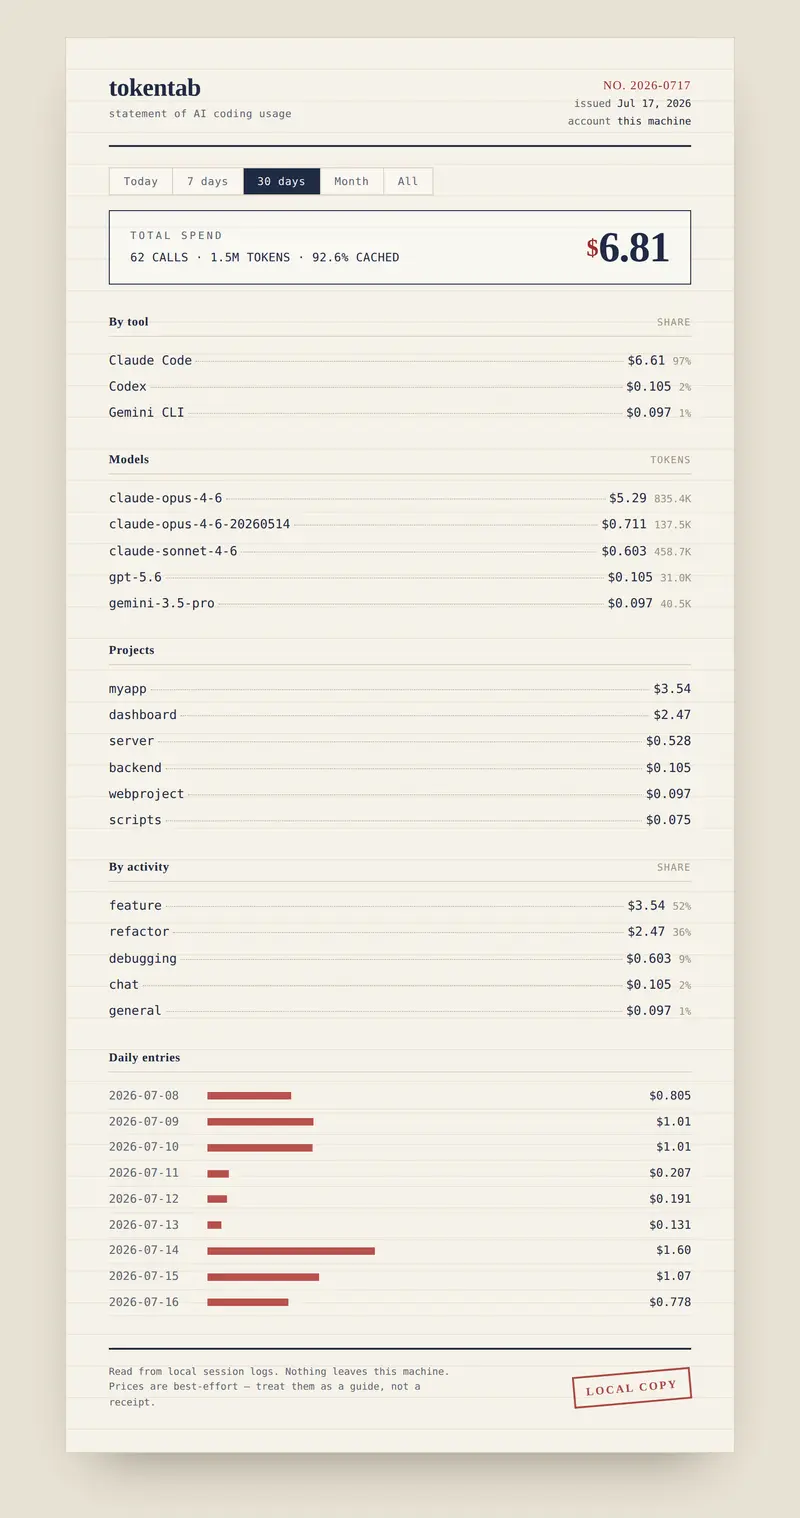
其核心价值在于将分散在不同工具目录中的原始日志转化为结构化成本视图,支持按模型、项目、日期及工作类型(如编码、调试、重构)进行多维细分。对于需要精细化管控 AI 开发支出的团队或个人,tokentab 提供了无需第三方服务介入的自托管审计方案。
克隆仓库后执行以下命令即可完成安装:
git clone https://github.com/crwdla/tokentab
cd tokentab
pip install .
python cli.py
安装完成后 tokentab 命令会自动加入系统路径。若希望以开发模式运行以便后续修改源码,可将 pip install . 替换为 pip install -e .,之后直接使用 tokentab 命令启动。
工具的唯一第三方依赖是 rich,用于终端表格渲染;Web 服务器、JSON 解析等模块均基于 Python 标准库,无需额外安装框架。若未安装某个支持的 AI 编码工具,程序会自动跳过对应日志源,仅展示实际存在的数据。
tokentab 开箱即用地支持三类主流 AI 编码工具的日志格式:
~/.claude/projects/**/*.jsonl~/.codex/sessions/**/rollout-*.jsonl~/.gemini/tmp/**/session-*.jsonCursor 的支持目前处于存根状态,尚未实现完整解析。
基础命令 python cli.py 默认展示过去 7 天的汇总数据。通过参数可灵活限定范围:
-today / -month:限定为当天或当月-p all:显示全部历史--provider claude:仅统计指定工具--project myapp:过滤特定项目--from YYYY-MM-DD --to YYYY-MM-DD:自定义时间窗口--json:输出机器可读格式,便于管道传输至 jq 或其他处理工具当输出被重定向或管道传输时,终端颜色码会自动禁用,避免转义字符污染下游内容。
此外,-web 参数可启动一个绑定于 localhost:4747 的轻量级 Web 仪表板。该界面基于 Python 标准库 HTTP 服务器实现,不依赖 Flask 等框架,每次请求实时从磁盘读取数据以避免缓存导致的陈旧展示。页面不调用任何外部 CDN,字体使用系统内置衬线与等宽字体,断网环境下仍可正常访问。可通过 --port 更改端口,或 --no-open 阻止自动打开浏览器。
令牌计数直接提取自各工具原生日志,不做估算。针对缓存令牌的差异处理是关键细节:Claude 将缓存读写分开记录,而 Gemini 的输入令牌包含缓存部分。tokentab 在计价前会将缓存令牌剥离,防止对相同内容重复计费。
价格表位于 tokentab/pricing/prices.py,以每百万令牌美元为单位手工维护。该设计有意避免联网获取实时价格——当供应商频繁重命名模型时,略微过时的静态表比运行时崩溃更可靠。模型名称匹配采用模糊策略,例如 claude-opus-4-6-20260514 仍能匹配到 claude-opus-4-6。若某模型显示 $0.00,表示未在价格表中找到对应条目,CLI 会明确提示而非静默归零,用户只需添加一行即可修复。
工作类型分类(编码/调试/重构/测试等)基于所用工具及会话首条消息的关键词进行确定性推断,不调用任何 AI 模型,保证速度且结果可人工校验。此分类仅为辅助提示,非精确标签。
添加新的 AI 工具支持只需在 tokentab/providers/ 下新增一个模块,实现返回 UsageRecord 列表的 collect() 函数,并在 __init__.py 中注册。下游的定价、分组、仪表板等功能均基于统一数据结构,无需额外适配。现有三个解析器可作为模板参考,其中 Claude 的实现最为简洁。
在解读输出数据时,以下模式值得留意:
这些观察是分析起点,而非结论。tokentab 的职责是准确呈现数据,对工作实质的判断仍取决于使用者自身。