AnyCoder
AnyCoder标志着 AI 辅助开发正从“辅助写代码”走向“替代写代码”,它不追求取代专业开发者,而是为非技术背景的创造者提供一个低门槛的入口。无论是设计师、产品经理,还是想快速验证想法的创业者,都可以通过自然语言,将自己的创意变为可运行的应用。
Meta AI 推出终端编码代理 Muse Code(测试版),由全新 Muse Spark 1.2 模型驱动。该组合专为大型代码仓库中的复杂软件工程任务设计,支持变更规划、代码编写与结果验证。其核心架构特征包括异步后台代理持久运行、本地只追加事件日志实现崩溃恢复,以及模型与 harness 的协同训练。
 Muse Code
Meta AI 推出终端编码代理 Muse Code(测试版),由全新 Muse Spark 1.2 模型驱动。该组合专为大型代码仓库中的复杂软件工程任务设计,支持变更规划、代码编写与结果验证。其核心架构特征包括异步后台代理持久运行、本地只追加事件日志实现崩溃恢复,以及模型与 harness 的协同训练。Muse Code 当前仅面向 macOS 和 Linux 提供安装脚本,Muse Spark 1.2 通过 Meta Model API 托管访问,未开放权重下载。
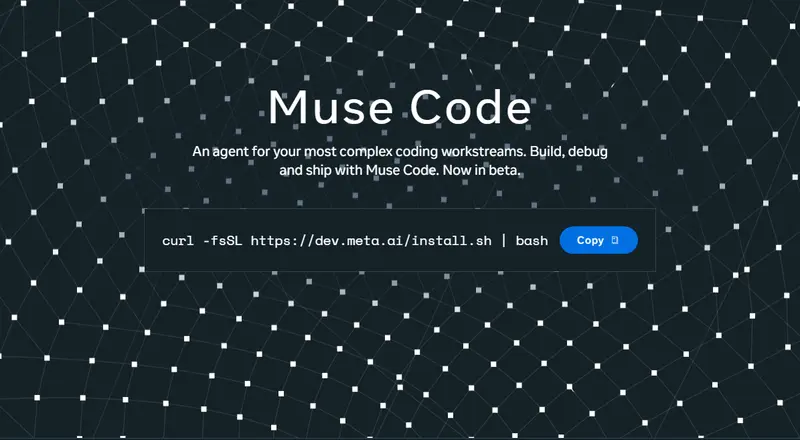
Muse Code 以测试版形式发布,部署路径明确但存在依赖约束:
curl -fsSL https://dev.meta.ai/install.sh | bash 一键安装,支持 macOS 与 Linux需注意,当前版本为测试阶段,生产环境使用前应评估稳定性与合规要求。
Muse Code 摒弃了按任务临时生成代理的传统模式,采用主代理循环加持久化异步后台代理的架构。后台代理在整个会话期间保持活跃,自主执行后续步骤并决定何时向主代理汇报,旨在减少多步骤任务中的冗余信息收集与人工干预。
运行时状态管理依赖本地只追加事件日志。每次模型调用、工具执行、用户审批及文件编辑均被顺序记录,形成单一可信数据源。Meta 声称该日志支持精确重放与重启安全——代理崩溃后可从断点无缝恢复,使长达数小时的任务具备容错能力。这一设计对长周期工程任务尤为关键,避免了因中断导致的全量重做。
Muse Spark 1.2 基于 1.1 版本迭代,专注于编码能力提升,同时维持通用代理性能。三项关键训练细节定义了其差异化优势:
评估方面,Meta 采用了异常具体的方法论:Terminal-Bench 2.1(89 项任务,pass@1 基于五次尝试)、DeepSWE v1.1(91 代码库、5 语言、113 任务)、内部 Coding Bench(440 项真实 PR 任务),均在隔离 Daytona 云沙盒中执行。对比对象包括 Grok 4.5、Claude Opus 5、GPT-5.6 Terra、Gemini 3.6 Flash 及 Kimi K3,但 Meta 明确指出其 harness 未针对第三方模型调优,跨模型比较需谨慎解读。
Meta 提供了一个 GPU 内核优化的实证案例,验证系统在极端负载下的稳定性与有效性。任务涉及 NVIDIA Hopper GPU 上的 KDA 与 MLA 内核,总时长达 24 小时,触发超 1000 次工具调用。
该案例不仅展示代码生成能力,更验证了异步代理与事件日志在超长任务中的工程可靠性。对于 HPC 与基础设施团队,此类场景是评估代理实用性的关键基准。