GPT-Realtime
gpt-realtime 的发布,不仅是技术迭代,更意味着 OpenAI 的语音能力已具备**企业级稳定性与功能性**。它不再只是一个演示功能,而是可以嵌入真实业务流程的工具。对于开发者而言,Realtime API 的全面开放,加上 SIP、MCP、图像输入等企业级功能的加入,意味着构建复杂语音应用的门槛正在降低。
“宇宙无敌表达训练系统”是一款面向口语精准度训练的本地桌面应用,核心流程为实时语音识别、词库匹配与AI反馈生成。语音识别环节基于Sherpa-ONNX实现完全离线处理,AI反馈模块则支持Groq、OpenAI、DeepSeek及Ollama等多后端接入。
 宇宙无敌表达训练系统
“宇宙无敌表达训练系统”是一款面向口语精准度训练的本地桌面应用,核心流程为实时语音识别、词库匹配与AI反馈生成。语音识别环节基于Sherpa-ONNX实现完全离线处理,AI反馈模块则支持Groq、OpenAI、DeepSeek及Ollama等多后端接入。
该工具将表达分析拆解为填充词、犹豫词、笼统词三类可量化指标,并提供六维度结构化报告,适用于演讲准备、沟通技巧提升等场景。所有语音数据在本地完成转写,仅AI反馈环节依赖网络(使用Ollama时可全程离线)。
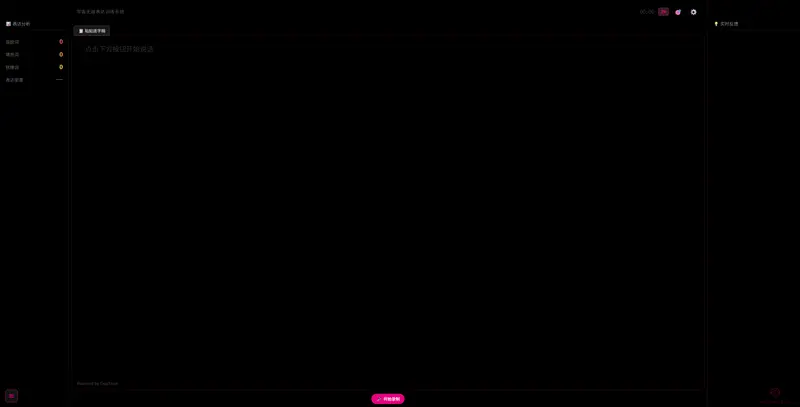
应用的功能设计围绕“即时感知—模式识别—改进建议”三层闭环展开:
emotion-lexicon.json词库,基于大连理工情感词库七大类结构扩展,包含130+情绪词(含强度分级)、25组笼统词→精准词映射、24个填充词、19个犹豫词、四级程度词梯度、10组抽象→具象转换示例及8组犹豫→直接对照部署流程分为依赖安装、模型下载、服务启动三步,对硬件要求较低但需确保麦克风权限已授予。
环境前置条件
模型下载注意事项
语音识别模型需手动下载至models/目录,推荐从GitHub Releases获取sherpa-onnx-streaming-paraformer-bilingual-zh-en.tar.bz2,解压后应包含encoder.int8.onnx、decoder.int8.onnx及tokens.txt三个文件。HuggingFace镜像可用但匿名下载存在速率限制,长时间传输易中断。
AI后端选型参考
| 后端 | 成本 | 响应速度 | 适用场景 |
|---|---|---|---|
| DeepSeek | 极低 | 快 | 高频练习、报告质量优先 |
| OpenAI | 中等 | 快 | 已有API额度、兼容生态 |
| Ollama | 免费 | 依硬件而定 | 完全离线、隐私敏感场景 |
| Groq | 低 | 极快 | 实时反馈延迟敏感 |
DeepSeek在报告生成质量与成本间平衡较优,推荐作为默认选项;若需彻底断网使用,Ollama是唯一可行方案,但反馈质量受限于本地模型能力。
该工具的价值在于提供可重复、可量化的表达模式觉察,而非替代人类教练或保证表达能力线性提升。需注意以下边界:
建议将本工具定位为“表达习惯的镜子”而非“表达能力的裁判”。有效使用方式是聚焦单一维度(如填充词频率)进行为期数周的定向训练,结合人工复盘校准机器判断,避免陷入分数焦虑或过度依赖自动化反馈。