TTSMaker
TTSMaker是一款在线文本转语音工具,也称为AI语音生成器,它可以将文本转换为音频,并且可以播放或下载音频文件。
 OpenSpeech
开源文本转语音(TTS)模型的质量已经追上甚至超越了部分商业服务,但寻找和测试它们的过程依然痛苦。
你通常需要在 GitHub、Hugging Face 和各类博客之间跳跃,克隆仓库,配置复杂的 CUDA 环境,还要祈祷权重文件能顺利下载。ElevenLabs 等商业服务虽然方便,但价格不菲。
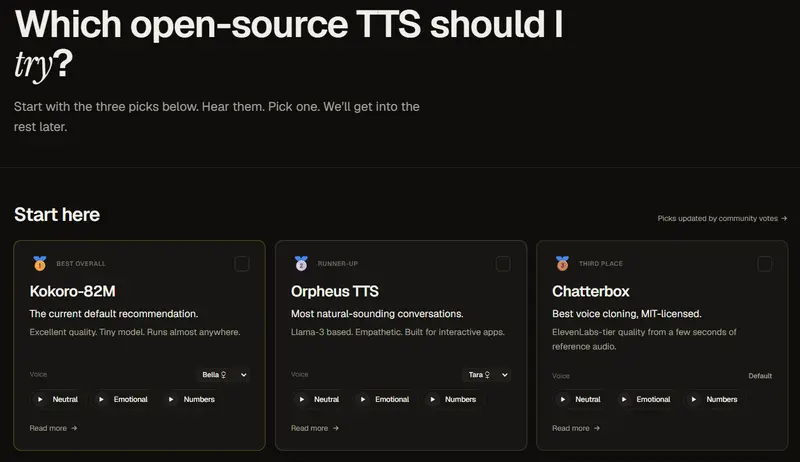
OpenSpeech 是一个开源 TTS 模型的开放目录,让每一款模型都在相同的条件下接受测试,以便你进行公平、直观的比较。
1. 统一的测试基准
2. 一站式信息聚合
3. 极简的维护与贡献
data/ 目录下的纯 JSON 文件中,结构简单透明。public/samples/ 目录。git clone https://github.com/sudomichael/openspeech
cd openspeech
npm install
npm run dev
由于样本音频已预先生成并提交,你无需 Replicate Token 即可在本地浏览和试听所有内容。
.env.local 中的 REPLICATE_API_TOKEN 后运行:
npx tsx scripts/generate-replicate.ts          # 全量生成
npx tsx scripts/generate-replicate.ts --missing  # 仅生成缺失样本
目前目录已 curated(精选)了 22 款 来自开源社区的 TTS 模型,涵盖约 40 种 不同的声音。这些模型代表了当前 OSS TTS 生态的最高水平,包括但不限于 Coqui TTS、Bark、VITS 变体等主流架构。