Mosi AI

6个月前发布 837 00

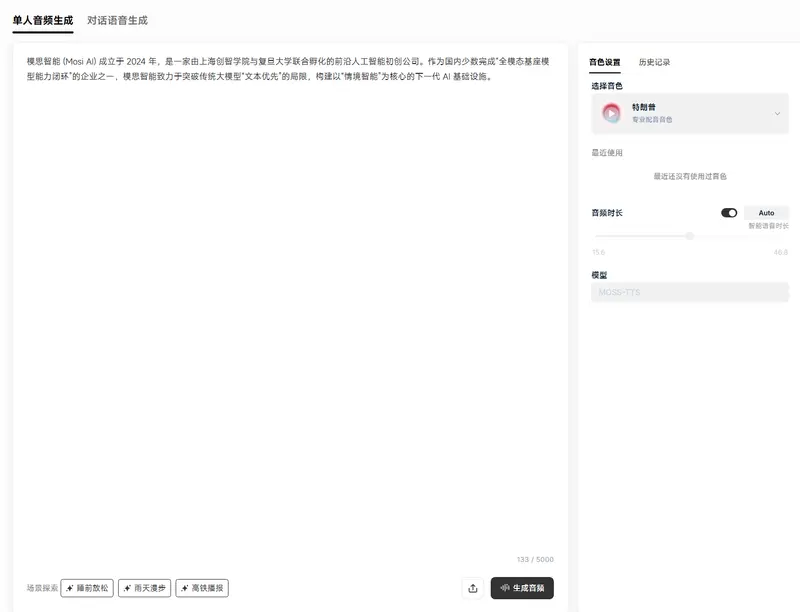
模思智能 (Mosi AI) 成立于 2024 年,是一家由上海创智学院与复旦大学联合孵化的前沿人工智能初创公司。作为国内少数完成“全模态基座模型能力闭环”的企业之一,模思智能致力于突破传统大模型“文本优先”的局限,构建以“情境智能”为核心的下一代 AI 基础设施。
所在地:
中国
收录时间:
2026-04-28

模思智能 (Mosi AI) 成立于 2024 年,是一家由上海创智学院与复旦大学联合孵化的前沿人工智能初创公司。作为国内少数完成“全模态基座模型能力闭环”的企业之一,模思智能致力于突破传统大模型“文本优先”的局限,构建以“情境智能”为核心的下一代 AI 基础设施。

Mosi AI

核心团队与背景

  • 学术渊源深厚:团队核心成员长期深耕预训练、大模型与多模态方向。
  • 首席科学家:邱锡鹏教授(复旦大学教授、国家杰出青年科学基金获得者、上海创智学院全职导师),国内深度学习与自然语言处理领域的领军人物。
  • CEO:李世民,邱锡鹏教授门下硕博连读体系出身,兼具深厚的学术背景与商业化视野。

技术演进里程碑

模思智能在短短几年内完成了从对话模型到全模态统一架构的快速迭代:

年份关键成果意义
2023MOSS发布类 ChatGPT 的开源对话式大模型,引发社区广泛关注。
2023SpeechGPT验证了“离散化端到端语音大模型”的技术路径,打破语音与文本的壁垒。
2024AnyGPT将语音、文本、图像与视频统一映射至离散 Token 体系,实现真正的全模态统一建模。
2025MOSS-TTSD / NEX推出高保真语音合成模型及具备能动性的 NEX 模型体系,强化交互真实感与自主性。
2026MOSS-Audio发布开源音频理解模型,实现语音、环境声、音乐的深度统一理解与推理。

核心技术范式:情境智能 (Contextual Intelligence)

区别于主流大模型以文本为中介的处理方式,模思智能确立了三大核心技术支柱:

1. 原生语音理解与生成

  • 去中转化:研发 MOSS-Speech 等模型,跳过传统的“语音→文本→语音”转录环节,直接对声学信号进行建模。
  • 情感捕捉:能够精准捕捉语调、停顿、情绪等非语言信息,大幅提升交互的自然度与拟人感。

2. 全模态统一 Token 架构

  • 模态壁垒突破:通过 AnyGPT 架构,将文本、语音、图像、视频全部转化为统一的离散 Token 序列。
  • 高效交互底座:这种统一表示法为具身智能(Embodied AI)、智能终端等需要多感官协同的场景提供了高效的底层支持。

3. 深度情境理解引擎

  • 长期记忆:能够记忆用户长期偏好,构建个性化用户画像。
  • 语境解读:深度解读对话上下文与物理场景语境,实现从“被动问答”到“主动感知”的跨越,提供更具同理心和逻辑性的智能交互。

应用前景

模思智能的技术体系特别适用于对实时性、自然度及多模态融合要求极高的场景:
  • 具身智能机器人:让机器人能“听懂”语气、“看懂”场景,并做出符合情境的反应。
  • 下一代智能终端:为手机、耳机、车载系统提供原生多模态交互能力,摆脱对屏幕和键盘的依赖。
  • 虚拟人与数字伴侣:提供具备情感深度和长期记忆能力的虚拟交互对象。
  • 无障碍辅助技术:通过原生语音与情境理解,为视障或听障人士提供更精准的环境感知辅助。

相关导航