Condense

4个月前发布 103 00

Condense.chat 的代理可压缩编码智能体的上下文,利用两个内部模型,在深度会话中将令牌费用削减高达 72%。
所在地:
美国
收录时间:
2026-07-08
CondenseCondense

在 AI 辅助编程日益普及的今天,开发者们发现了一个隐蔽的成本黑洞:上下文冗余。当使用 Claude Code、Codex 等智能体进行长会话开发时,模型在每次交互中都会重新读取完整的系统提示和历史对话。随着会话深入,这些“陈旧”的上下文占据了绝大部分 Token 消耗,导致账单激增。
Condense

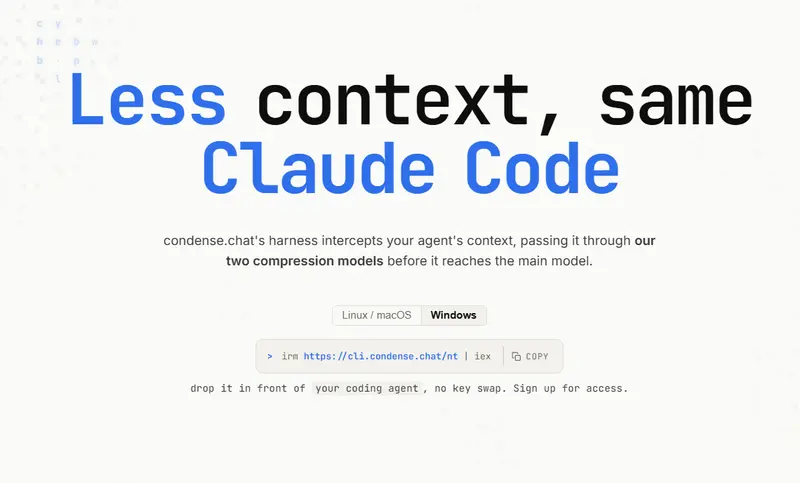
Condense.chat 推出的上下文压缩代理正是为了解决这一痛点。它作为一个中间层部署在智能体与上游模型之间,通过两个内部模型对请求进行实时压缩,据实测可将令牌费用降低高达 72%。

核心机制:双模型协同压缩

Condense 并非简单地截断历史,而是采用了一套精细的“提取+重写”策略,确保关键信息不丢失的同时大幅缩减体积:
  1. Helene 1(提取模型):
    • 作为第一道防线,它对每个 Token 进行评分,剥离那些对当前推理无关紧要的内容。
    • 它保留的是智能体所见内容的严格子集,确保在进入缓存前去除噪音。
  2. Adeline 1(扩散重写器):
    • 针对已经完成的智能体循环(即过去的交互步骤),Adeline 1 会将其打包成简短的摘要。
    • 摘要包含关键要素:意图、文件路径、标识符、错误信息及代码片段,体积仅占原始 Token 的约 9%。
  3. 骨架保留原则:
    • 为了保证推理的准确性,Condense 严格保留了“骨架”部分:系统提示、用户最新消息、最终答案以及配对的工具调用结果。
    • 这些核心内容逐字节保留,从不被重写或篡改,确保模型当前的工作集保持原始状态。
Condense

实测数据:深度会话节省显著

在对 12 个真实编码会话和 18,333 次助手交互的分析中,Condense 展现了惊人的成本优化能力:

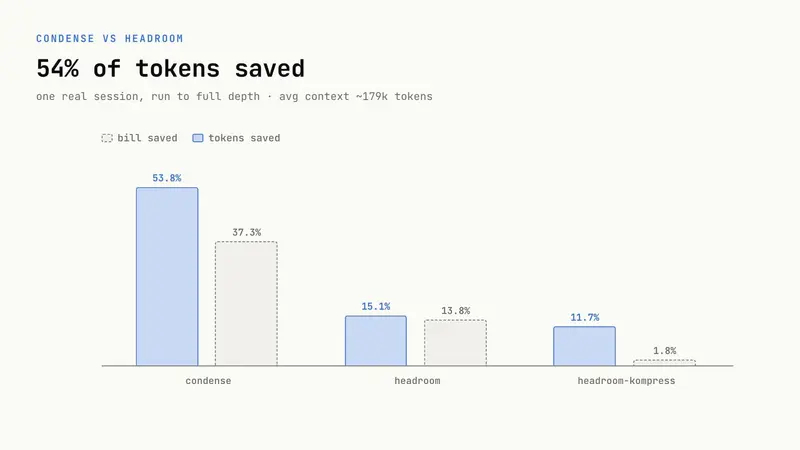
  • 总体节省:平均账单下降 66%。
  • 极端案例:在一个长达 938 次交互的重放会话中,账单下降了 72.3%。
    • Claude Sonnet:从 $154 降至 $43。
    • Claude Opus:从 $771 降至 $214。
  • 保真度:相对于未压缩的记录,答案保真度报告为 94.2%,证明压缩并未显著影响代码生成的质量。
  • 规模效应:会话越长,节省效果越明显。在超过 400,000 个 Token 的长链会话中,节省比例超过 53%。

部署与兼容性

Condense 的设计遵循“即插即用”原则,无需更换 API 密钥或修改现有代码逻辑:

  • 透明代理:只需一条命令即可将工具置于现有智能体之前。团队只需将基础 URL 指向 Condense 的路由,即可保留原有的 OpenAI 或 Anthropic 密钥。
  • 广泛支持:目前支持在 macOS、Linux 和 Windows 上驱动 Claude Code、Codex 和 OpenCode。
  • 开源验证:为了建立信任,Condense 已在 GitHub 上发布了完整的测量管道,包括成本拆分研究和重放工具,允许开发者在无密钥环境下自行复现和验证数据。

相关导航

腾讯云代码助手

腾讯云代码助手

腾讯云代码助手是由腾讯云自研的一款开发编程提效辅助工具,开发者可以通过插件的方式将腾讯云代码助手安装到编辑器中辅助编程工作(VS Code 或者 JetBrians 系列 IDE);而腾讯云代码助手插件将提供:自动补全代码、根据注释生成代码、代码解释、生成测试代码、转换代码语言、技术对话等能力。通过腾讯云代码助手,开发者可以更高效地解决实际编程问题,提高编程效率和代码质量。