
河北工厂网
河北工厂网 是一个专注于河北制造业的公益性信息基础设施。它不是交易平台,不卖排名,不做撮合,而是致力于解决采购商“找不到真工厂”的核心痛点,提供一份免费、透明、可验证的河北工厂名录。
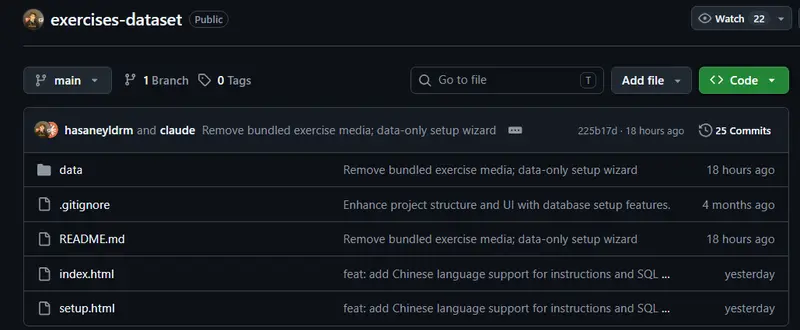
Exercises Dataset是一个开发者设置向导 + 结构化的多语言训练动作数据集 — 基于 1,324 个训练动作,构建您自己的健身应用后端。包含动作类别、训练部位、所需器械、目标肌群与辅助肌群数据,并提供 6 种语言的分步执行说明。动作媒体文件不包含在内。
 Exercises Dataset
对于想要开发健身应用、运动推荐系统或健康类 AI 助手的开发者来说,最头疼的往往不是代码逻辑,而是数据的获取与清洗。如何确保练习名称准确?如何覆盖多语言用户?如何处理复杂的肌肉群关联?
Exercises Dataset 提供了一个经过精心整理的解决方案。这是一个包含 1,324 个健身练习的结构化数据集,旨在成为你构建后端服务的坚实底座。它不仅提供了基础的元数据,还集成了多语言说明和完整的开发者工具链。
该数据集基于 ExerciseDB v1 进行深度清洗和扩展,每条记录都包含了构建专业健身应用所需的完整字段:
media_id,方便有权限的开发者通过官方 CDN 调用资源。Exercises Dataset 不仅仅是一堆 CSV 或 JSON 文件,它提供了一套完整的“开箱即用”工具,极大降低了集成门槛。
index.html)无需部署服务器,直接在浏览器中打开即可使用。它提供了一个功能完备的客户端界面,支持:
无论你的技术栈是 SQL Server、PostgreSQL、MySQL 还是 SQLite,数据集都提供了对应的 CREATE TABLE 语句。更贴心的是,你可以在浏览器中直接生成包含所有 1,324 条记录的 .sql 插入文件,几秒钟即可完成数据库 seeding。
为了加速后端集成,仓库提供了 JavaScript、Python、C#、Java、PHP、Go 和 cURL 的复制粘贴级客户端代码示例。只需输入你的 Base URL,这些示例就能实时更新并 ready-to-use。
如果你希望快速搭建一个生产级的 REST API,数据集甚至包含了一个结构化的 Prompt。将其粘贴给 ChatGPT、Claude 或 Gemini,即可自动生成基于 Express.js、FastAPI、ASP.NET Core、Spring Boot 等框架的完整后端代码。
Exercises Dataset 证明了高质量的数据集不仅能节省开发时间,更能通过标准化的结构提升应用的專業度。对于独立开发者或小团队而言,它是一个不可多得的“加速器”。