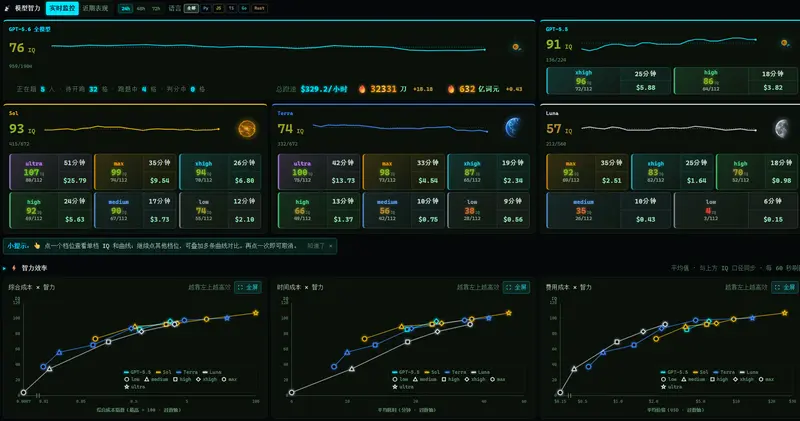
Codex 雷达是一个由社区众测驱动的开源编程能力基准测试平台。它旨在解决官方跑分静态、滞后且缺乏透明度的问题,通过让全球开发者利用自己的 Codex 订阅额度实时运行真实编程题,构建出一张动态更新的2,128 格模型能力雷达图。

在这里,没有黑盒评分,只有基于真实代码执行结果的“通过率”。你可以直观地看到 GPT-5.5、GPT-4o 等主流模型在不同推理档位下的实时表现,一眼识破模型是否“降智”。
核心机制:2,128 个格子的真相
- 📊 多维矩阵:雷达图由 112 道真实开源编程题 × 19 个模型/推理档位组成。
- 🔴 实时点亮:每个格子代表一个模型在特定题目和推理设置下的最近实测通过率。数据由社区志愿者实时贡献,随时间动态刷新。
- ⚖️ 同场对照:将上一代标杆模型(如 GPT-5.5)拉入同场竞技,通过横向对比,让“降智”或“进化”无处遁形。
为什么值得参与?
1. 🔍 拒绝盲猜,数据说话
官方成绩单往往是“最佳状态”下的静态展示,而 Codex 雷达反映的是此刻你在生产环境中可能遇到的真实水平。无论是日常波动还是版本迭代带来的性能变化,都能在这里第一时间捕捉。
2. 🛡️ 绝对公平,防刷机制
- 服务器重跑判分:用户仅上传代码补丁,服务器在隔离的干净环境中重新运行测试用例并判分。自报结果无效,彻底杜绝作弊。
- 全程轨迹审计:禁止联网搜索,异常提交自动隔离复核,确保每一份数据都源自模型的独立推理。
3. 💎 额度透明,亏损有补
- 透明价签:认领任务前,系统会显示该任务预计消耗的额度百分比(约占 7 天额度的比例),让你量力而行。
- 失败也计分:积分等于烧掉的额度。即使题目没做出来,你的“失败数据”对评估模型边界同样有价值,因此依然获得积分奖励。
- 故障补偿:若因平台自身故障导致任务中断或额度白烧,平台将照价补偿积分。
4. 🏆 攒积分,登天梯
- 永久累计:总榜积分永不缩水,记录你的每一次贡献。
- 江湖地位:你的名字和 GitHub 头像将出现在雷达图的对应格子上,登上贡献者天梯,成为社区公认的“雷达守护者”。
如何参与?四步轻松上车
无需编写任何命令,只需简单的点击与复制:
- GitHub 登录:仅用于身份确认和发放访问令牌,不触碰你的 OpenAI/Codex 账号凭据。
- 认领格子:在大表中挑选感兴趣的题目-模型组合(最多 10 个),或直接点击“🎯 系统推荐 10 格”一键领取。
- 复制运行:复制生成的命令,粘贴到你的本地 Codex 终端中。Codex 会自动配置环境、运行测试并上传结果。你可以在此期间去忙别的事情。
- 查看成果:任务完成后,回到网站查看对应的格子被点亮,你的名字随之上榜。
安全与隐私承诺
- 凭据本地化:你的 Codex 订阅凭据全程保留在本地机器上,绝不经过 Codex 雷达的服务器。
- 自动脱敏:上传前,客户端会自动扫描并剔除代码中的密钥敏感信息,带密钥的补丁会被直接拒收。
- 断点续跑:支持任务中断后的断点续传,避免重复消耗额度。
 Codex 雷达