在企业级检索增强生成(RAG)系统中,传统的“HTML 转文本”解析流程正成为准确性与效率的瓶颈。PixelRAG,由加州大学伯克利分校、普林斯顿大学、EPFL 和 Databricks 联合研究团队提出,彻底颠覆了这一范式。它不再将网页解析为扁平化的纯文本,而是直接将其渲染为屏幕截图,利用视觉语言模型(VLM)对图像进行索引与检索。研究表明,这种方法不仅将检索准确率提升了 18.1%,更因大幅减少上下文冗余,使 AI 智能体的 Token 成本降低了 10 倍。

核心痛点:为什么文本解析器会失败?
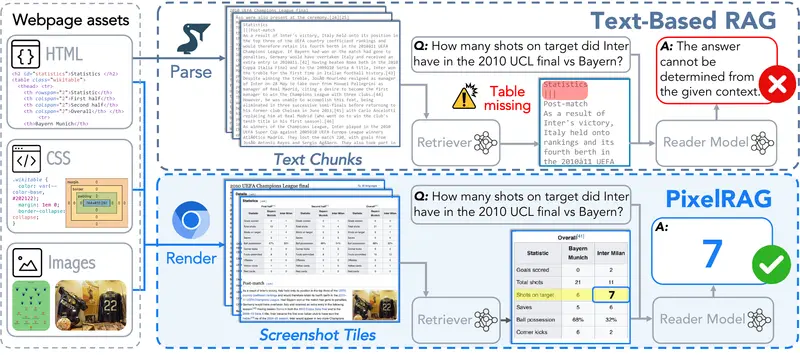
传统 RAG 依赖解析器将 HTML 转换为文本,这一过程不可避免地导致三种关键信号丢失:
- 解析器损失:复杂的嵌套结构、样式及空间关系被彻底破坏。
- 排名损失:关键词密集但无关的信息框往往排在真正的答案之前。
- 阅读器损失:扁平化的文本导致 LLM 难以正确归属信息,产生幻觉。
PixelRAG 工作原理:端到端的视觉检索
PixelRAG 用四个完全基于渲染截图的阶段取代了传统文本流水线:
- 渲染 (Rendering):使用 Playwright 以固定视口(875px)渲染网页,并切片为 1024px 高的图块,保留完整的视觉布局。
- 索引 (Indexing):利用 Qwen3-VL-Embedding-2B 将每个图像图块编码为 2048 维向量,存入 FAISS 近似最近邻索引。
- 训练 (Training):在合成对比数据上微调检索模型,使用动态硬负例挖掘优化排序能力。
- 存储 (Storage):采用按需渲染策略,避免持久存储海量截图(维基百科全量需 5.6TB),仅在索引时生成。
性能表现:全面超越文本基线
在六个涵盖事实问答、表格查询及多模态检索的基准测试中,PixelRAG 均表现优异:
| 基准测试 | PixelRAG 准确率 | 最强文本 RAG 准确率 | 提升幅度 |
|---|
| SimpleQA (事实问答) | 78.8% | 71.6% | +7.2% |
| Table QA (结构化表格) | 48.8% | 42.5% | +6.3% |
| 综合平均 | 显著领先 | – | +18.1% (相对提升) |
- 成本优势:在处理 360 万个提示 Token 的任务中,PixelRAG 相比文本检索所需的 3750 万 Token,实现了约 10 倍 的成本节省。
挑战与落地建议
- 未解难题:视觉分块:目前尚缺乏像文本语义分块那样成熟的“视觉语义分块”标准,如何根据视觉内容意义而非固定像素切割图片仍是研究热点。
- 混合部署策略:研究者建议,企业无需立即推翻现有系统,而是将 PixelRAG 作为增强层。结合文本搜索的广度与视觉搜索的结构精度,构建混合检索系统,是近期最实用的落地路径。