
Co-STORM
Co-STORM 是斯坦福大学开发的一个 AI 工具,属于 STORM项目的扩展。它通过模拟专家对话和整理信息,自动生成长篇、事实准确的 Wikipedia 风格文章,特别注重写作前的准备阶段。研究表明,它允许用户引导研究过程,确保生成的内容符合需求。
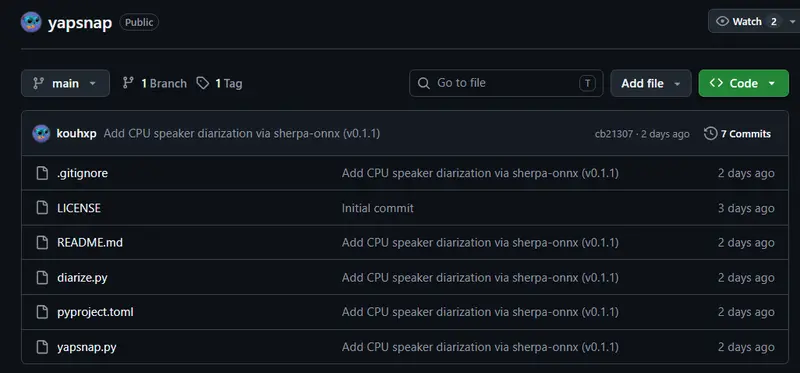
 yapsnap
在视频内容爆炸式增长的今天,将音频转化为可搜索、可编辑的文本是一项高频需求。然而,传统的转录工具往往面临两大困境:要么依赖昂贵的云端 API 且存在隐私泄露风险,要么需要高性能 GPU 和本地部署复杂的深度学习框架。
yapsnap 是一个轻量级、纯 CPU 运行的命令行工具,能够将任何视频 URL 或本地音频文件快速“快照”为纯文本。无需 GPU,无需云端,只需一条命令,即可在你的笔记本上以数倍于实时的速度完成转录。
sherpa-onnx、numpy 和 yt-dlp,无需安装庞大的 PyTorch 或云端 SDK。yt-dlp 负责下载最佳音频流,ffmpeg 负责解码为 16kHz 单声道 PCM,全程自动化处理。--timestamps 参数,可为每句话添加 [MM:SS] 标记,即使加速转录,时间戳依然精准对应原始音频。--diarize 参数,自动识别并标记不同说话人(如 SPEAKER_00, SPEAKER_01),完美适用于访谈、会议记录等场景。--model 轻松切换支持法语、德语、西班牙语、中文等 10+ 种语言。确保系统中已安装 ffmpeg 并加入 PATH。
pip install yapsnap
# 转录 YouTube 视频
yapsnap "https://www.youtube.com/watch?v=dQw4w9WgXcQ"

# 转录本地音频并添加时间戳
yapsnap meeting.mp4 --timestamps

# 转录访谈录音并标记说话人
yapsnap interview.mp3 --diarize

# 指定输出路径
yapsnap podcast.mp3 -o ~/notes/episode.txt
注:首次运行时会自动下载模型,后续运行完全离线。
| 参数 | 说明 | 示例 |
|---|---|---|
--timestamps | 添加句子级时间戳 [MM:SS] | yapsnap video.mp4 --timestamps |
--diarize | 启用说话人分离,标记 SPEAKER_XX | yapsnap call.mp3 --diarize |
--num-speakers N | 指定已知说话人数量,提高准确率 | yapsnap call.mp3 --diarize --num-speakers 2 |
--speed 1.0 | 禁用音频加速,以原始速度处理 | yapsnap input.mp3 --speed 1.0 |
--keep-audio | 保留下载的临时音频文件 | yapsnap "https://..." --keep-audio |
-o path | 自定义输出文件路径 | yapsnap input.mp4 -o ./transcripts/out.txt |
yt-dlp 下载最佳音频流至临时目录。ffmpeg 将媒体转换为标准的 16kHz 单声道 PCM 格式。--timestamps,根据标点符号将 Token 分组为句子,并映射回原始时间。--diarize,进行第二遍处理:通过声纹聚类识别说话人,并为每个句子分配对应的说话人标签。--num-speakers 参数。SPEAKER_00)仅在单次运行内有效,不同文件间的同一说话人不会被关联。