vLLM

6个月前发布 236 00

vLLM 是一个由加州大学伯克利分校开发的开源 LLM 推理和服务库。其核心创新——PagedAttention 算法,彻底解决了 KV Cache 的内存瓶颈问题,实现了比 HuggingFace Transformers 高达 24 倍 的吞吐量提升,且无需修改任何模型架构。
所在地:
美国
收录时间:
2026-05-06
其他站点:

在大语言模型(LLM)日益普及的今天,如何高效、低成本地部署和服务这些模型成为一大挑战。传统的推理库往往受限于内存管理效率,导致即使在昂贵的硬件上,推理速度也令人沮丧。

vLLM 是一个由加州大学伯克利分校开发的开源 LLM 推理和服务库。其核心创新——PagedAttention 算法,彻底解决了 KV Cache 的内存瓶颈问题,实现了比 HuggingFace Transformers 高达 24 倍 的吞吐量提升,且无需修改任何模型架构。

vLLM

为什么 vLLM 如此强大?

1. 超越 SOTA 的性能表现

在基准测试中,vLLM 展现了压倒性的优势:

  • vs HuggingFace Transformers:吞吐量提升高达 24 倍。
  • vs Text Generation Inference (TGI):吞吐量提升高达 3.5 倍。
  • 硬件友好:在 NVIDIA A10G (LLaMA-7B) 和 A100 (LLaMA-13B) 上均表现卓越,让小型研究团队也能负担得起高质量的 LLM 服务。

2. 核心秘诀:PagedAttention

传统 LLM 服务的主要瓶颈在于 KV Cache(键值缓存)的内存管理:

  • 问题:KV Cache 体积巨大(LLaMA-13B 单序列可达 1.7GB)且长度动态可变。现有系统因内存碎片化和过度预留,浪费了 60%-80% 的显存。
  • 解决方案:vLLM 引入 PagedAttention,灵感来自操作系统的虚拟内存分页机制。
    • 非连续存储:将 KV Cache 划分为固定大小的“块”(Block),允许它们在物理内存中非连续存储。
    • 按需分配:通过块表(Block Table)映射逻辑块到物理块,新 Token 生成时按需分配物理块。
    • 极低浪费:内存浪费仅发生在最后一个块,总体浪费率低于 4%。

3. 高效的内存共享

PagedAttention 天然支持内存共享,类似于进程共享物理页面:

  • 并行采样优化:在并行采样或束搜索(Beam Search)中,多个输出序列可以共享提示(Prompt)部分的 KV Cache 物理块。
  • 写时复制(Copy-on-Write):通过引用计数和 CoW 机制确保安全性。
  • 效果:复杂采样算法的内存开销降低高达 55%,吞吐量进一步提升 2.2 倍。
vLLM

核心特性一览

  • 极高吞吐量:连续批处理(Continuous Batching)、分块预填充(Chunked Prefill)。
  • 广泛兼容:无缝集成 Hugging Face 模型,支持 200+ 种架构(Llama, Qwen, Gemma, Mixtral, DeepSeek-V3 等)。
  • 标准化接口:内置 OpenAI 兼容 API 服务器,轻松替换现有服务。
  • 高级优化:支持 FP8/INT8/INT4/GPTQ/AWQ/GGUF 等多种量化格式,支持多 LoRA 适配,内置推测解码加速。
  • 灵活执行:优化的注意力内核,支持前缀缓存(Prefix Caching)。

快速开始

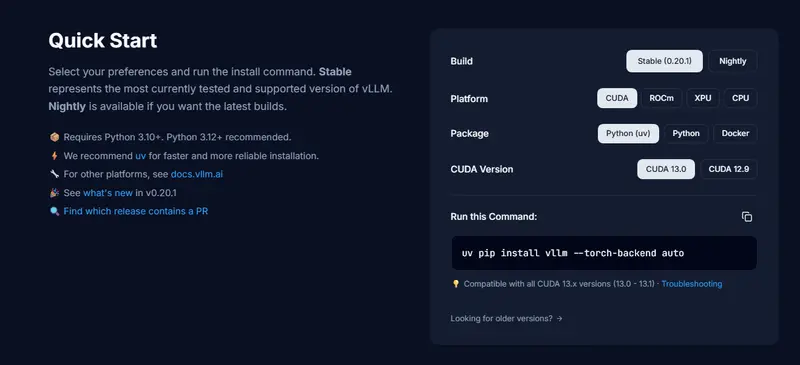
1. 安装

pip install vllm

2. 离线推理示例

from vllm import LLM

# 加载模型
llm = LLM(model="lmsys/vicuna-7b-v1.3")

# 生成文本
prompts = ["Hello, my name is", "The capital of France is"]
outputs = llm.generate(prompts)

for output in outputs:
    print(output.outputs[0].text)

3. 在线服务部署

启动兼容 OpenAI API 的服务端:

python -m vllm.entrypoints.openai.api_server --model lmsys/vicuna-7b-v1.3

调用接口:

curl http://localhost:8000/v1/completions \
    -H "Content-Type: application/json" \
    -d '{
        "model": "lmsys/vicuna-7b-v1.3",
        "prompt": "San Francisco is a",
        "max_tokens": 7,
        "temperature": 0
    }'
💡 适用场景

  • 高并发聊天机器人:利用连续批处理和高吞吐量,支撑大量用户同时在线。
  • 私有化模型部署:在有限显存资源下运行更大参数量的模型。
  • 复杂采样任务:需要并行采样或束搜索的高质量文本生成场景。
  • 多租户服务:通过多 LoRA 支持,为不同用户提供定制化模型体验,无需加载多个完整模型。

相关导航