Duix
Duix Mobile是一个可部署在手机或嵌入式屏幕的实时对话数字人 SDK。开发者可以轻松集成自有或第三方的大语言模型(LLM)、语音识别(ASR)和语音合成(TTS)服务,快速构建能与用户自然对话的数字人界面。Duix Mobile 支持一键跨平台部署(Android/iOS),上手门槛低,适用于智能客服、虚拟医生、虚拟律师、虚拟陪伴、虚拟教学等多种应用场景。
 CyberVerse
 是一个开源的数字人智能体平台,旨在让 AI 智能体“活”起来。它支持低延迟、无限时长的实时视频通话,让你能与一个能看、能听、能面对面交流的 AI 进行自然互动。只需一张照片,即可生成具备实时面部动画、自然口型同步和待机呼吸感的数字人,无需复杂的 3D 建模或动作捕捉。
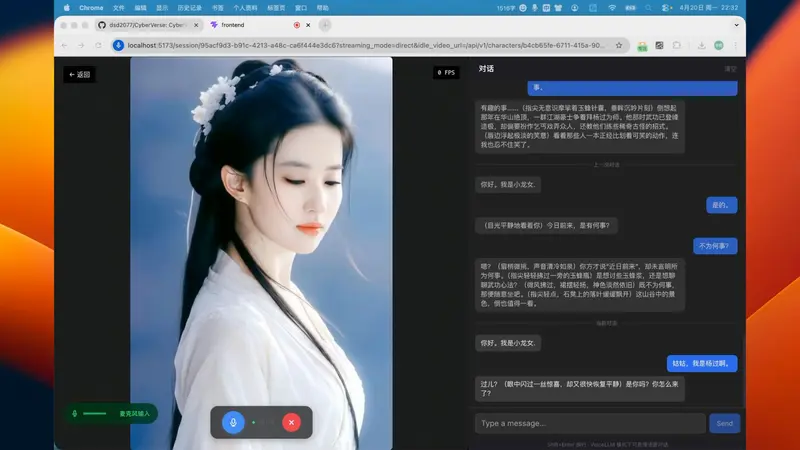
实时视频通话对 GPU 算力有较高要求。以下是主要模型的运行基准:
| 模型 | 档位 | GPU | 分辨率 | FPS | 实时运行? |
|---|---|---|---|---|---|
| FlashHead 1.3B | Pro | RTX 5090 (x2) | 512×512 | 25+ | ✅ |
| FlashHead 1.3B | Lite | RTX 4090 (x1) | 512×512 | 25+ | ✅ |
| FlashHead 1.3B | Pro | RTX 4090 (x1) | 512×512 | ~10.8 | ❌ (卡顿) |
| LiveAct 18B | — | RTX PRO 6000 (x1) | 256×417 | 20 | ✅ |
建议:若显存或算力有限,请选择 FlashHead Lite 模式或降低分辨率以保持流畅度。
# 1. 克隆仓库
git clone https://github.com/dsd2077/CyberVerse.git
cd CyberVerse

# 2. 创建 Python 环境
conda create -n cyberverse python=3.10
conda activate cyberverse

# 3. 配置环境变量
cp infra/.env.example .env
# 编辑 .env,填入豆包语音 API Key (DOUBAO_ACCESS_TOKEN, DOUBAO_APP_ID)

# 4. 下载模型权重 (以 FlashHead 为例)
pip install "huggingface_hub[cli]"
huggingface-cli download Soul-AILab/SoulX-FlashHead-1_3B --local-dir ./checkpoints/SoulX-FlashHead-1_3B
huggingface-cli download facebook/wav2vec2-base-960h --local-dir ./checkpoints/wav2vec2-base-960h

# 5. 更新配置
# 编辑 cyberverse_config.yaml,确认 checkpoint_dir 路径正确

# 6. 安装加速库 (可选但推荐)
pip install sageattention==2.2.0 --no-build-isolation
pip install flash_attn==2.8.0.post2 --no-build-isolation

# 7. 安装项目依赖
make setup
make inference (等待日志显示 Active avatar model initialized)make servermake frontend浏览器打开 http://localhost:5173,上传照片,开始你的第一次视频通话。