Nothing Playground
Nothing 推出 Playground,并非为了立刻取代传统应用开发,而是试探一种新的可能性:让用户用一句话表达需求,由 AI 实时生成可用工具。
 在线隐私过滤器(Privacy Filter Online)
在线隐私过滤器 (Privacy Filter Online) 是一款完全运行在浏览器端的免费隐私保护工具。它利用 OpenAI 开源的 privacy-filter 模型,通过 Transformers.js 在本地进行推理,能够精准识别并遮蔽文本及图片中的个人身份信息(PII),如姓名、邮箱、电话、地址、账号、密钥等。
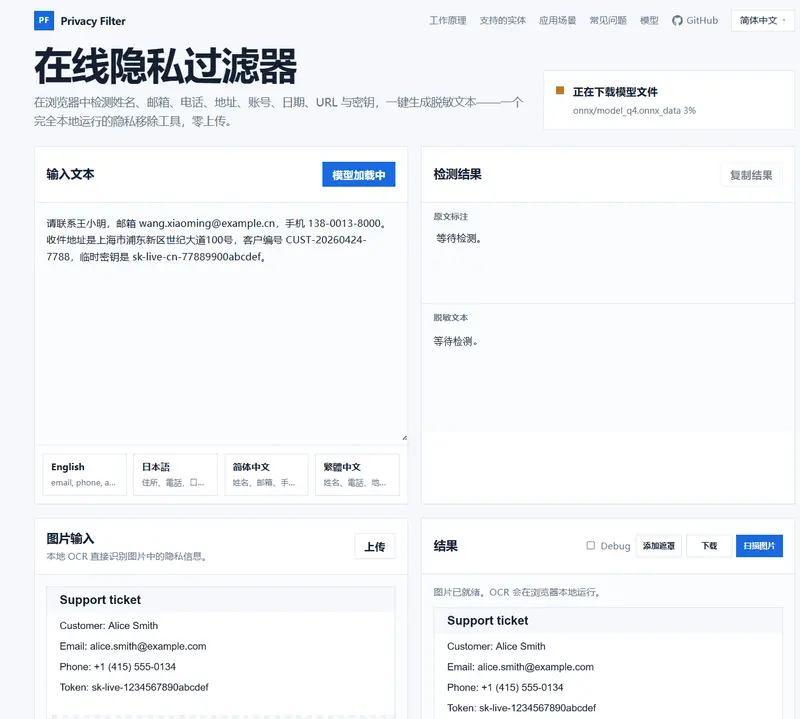
核心承诺:文本永不离开你的设备。无服务器、无上传、无追踪,确保数据绝对安全。
private_person (私人姓名)private_email (私人邮箱)private_phone (私人电话)private_address (私人地址)account_number (账号/银行卡号)private_date (私人日期/生日)private_url (私人链接)secret (API Key/密码/令牌)tesseract.js,支持上传图片或截图,自动识别其中的文字并遮蔽敏感区域,实现“所见即所得”的隐私打码。| 层级 | 选型 |
|---|---|
| 框架 | Astro 5 |
| 样式 | Tailwind CSS v4 |
| ML 运行时 | @huggingface/transformers (Transformers.js) |
| 核心模型 | openai/privacy-filter (1.5B 参数, 50M 活跃参数) |
| OCR 引擎 | tesseract.js |
| 部署 | Cloudflare Workers / 任意静态托管 |
pnpm install
pnpm dev
首次运行时,浏览器会自动从 Hugging Face 下载模型权重并缓存。
pnpm build       # 输出到 ./dist
pnpm preview     # 本地预览构建产物
pnpm deploy # 执行 build 并通过 wrangler 部署
注意:由于模型推理需要
SharedArrayBuffer,生产环境必须配置以下 HTTP 响应头:
Cross-Origin-Opener-Policy: same-originCross-Origin-Embedder-Policy: require-corpCloudflare Worker (
src/worker.ts) 已自动注入这些头部。若部署到其他平台,请自行配置。
Q: 我的文本会被上传到服务器吗?
A: 绝对不会。 推理过程完全在浏览器本地通过 Transformers.js 执行。除了首次从 Hugging Face 下载模型文件外,没有任何数据会离开你的设备。
Q: 为什么第一次检测比较慢?
A: 首次运行需要下载约 50MB 的模型权重文件。下载完成后,模型会缓存于浏览器 IndexedDB 中,后续访问速度将显著提升。
Q: 可以替代正则表达式脱敏吗?
A: 对于结构化数据(如标准邮箱格式),正则表达式依然高效。但对于自然语言中的非结构化隐私信息(如“我叫张三,住在北京市朝阳区…”),基于上下文的 AI 模型准确率远高于正则。建议两者结合使用以获得最佳覆盖率。