video-use

6个月前发布 540 00

video-use 是一个开源技能(Skill),它将 Claude Code 转变为一个全自动的视频编辑助手。你只需将原始素材放入文件夹,通过自然语言描述你的剪辑意图(如“剪掉所有停顿和口头禅”、“制作一个快节奏的预告片”),Claude Code 就会自动分析、剪辑、调色、添加字幕并渲染出最终的 final.mp4。
所在地:
美国
收录时间:
2026-04-17
video-usevideo-use

video-use 是一个开源技能(Skill),它将 Claude Code 转变为一个全自动的视频编辑助手。你只需将原始素材放入文件夹,通过自然语言描述你的剪辑意图(如“剪掉所有停顿和口头禅”、“制作一个快节奏的预告片”),Claude Code 就会自动分析、剪辑、调色、添加字幕并渲染出最终的 final.mp4。
video-use

它摒弃了传统非线性编辑软件(NLE)中繁琐的时间轴拖拽,采用**“文本即时间轴”**的理念,让视频剪辑像写代码一样高效、精准且可版本控制。

核心亮点

1. 基于音频的智能剪辑

  • 自动去噪:精准识别并剪除“嗯”、“呃”等填充词、错误开头以及拍摄间隙的无效空白时间。
  • 词级精度:利用 ElevenLabs Scribe 进行高精度转录,提供词级时间戳和说话人分离,确保剪辑点落在语义边界上,而非生硬的帧切割。
  • 无缝音频过渡:在每个剪辑点自动应用 30ms 音频淡入淡出,彻底消除爆音和突兀感。

2. “阅读”而非“观看”视频

  • 高效上下文管理:LLM 不直接处理海量视频帧(那需要数千万 Token)。相反,它“阅读”两个层次的信息:
    • 第一层(主要):压缩后的转录文本 (takes_packed.md),包含时间戳、说话人和音频事件(如笑声、掌声)。仅约 12KB,极大降低 Token 消耗。
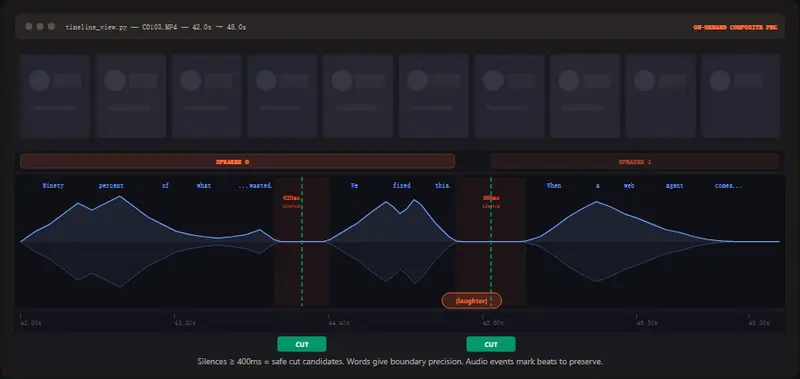
    • 第二层(按需):仅在决策模糊时,生成包含胶片条、波形图和标签的 PNG 缩略图 (timeline_view),供 LLM 进行视觉校验。
  • 结构化理解:类似于 browser-use 处理 DOM 而非截图,video-use 让 LLM 理解视频的结构而非像素。

3. 自动化后期与特效

  • 自动调色:支持预设风格(如暖色调电影感、中性鲜明)或自定义 ffmpeg 滤镜链。
  • 动态字幕:自动烧录字幕,默认采用流行的“双词大写块”风格(类似 Hormozi 风格),完全可自定义字体、颜色和位置。
  • 动画叠加:通过并行子代理调用 Manim、Remotion 或 PIL,根据脚本内容自动生成图表、高亮或动效叠加层。

4. 自评估与闭环修正

  • 渲染前自检:在向你展示任何预览之前,系统会在每个剪辑边界处运行自我评估,检查视觉跳跃、音频瑕疵或字幕错误。
  • 自动修复循环:如果发现问题,系统会自动调整编辑决策列表 (EDL) 并重新渲染,最多尝试 3 次,确保交付的是成品而非草稿。
  • 项目持久化:所有会话记忆和编辑逻辑保存至 project.md,你可以随时中断,下周回来继续从断点处开始工作。
video-use

快速开始

1. 安装与配置

# 克隆项目并链接到 Claude Code Skills 目录
git clone https://github.com/browser-use/video-use
cd video-use
ln -s "$(pwd)" ~/.claude/skills/video-use

# 安装 Python 依赖
pip install -e .

# 安装系统依赖
brew install ffmpeg           # 必需:视频处理核心
brew install yt-dlp           # 可选:用于下载在线视频素材

# 配置 API Key
cp .env.example .env
# 编辑 .env 文件,填入你的 ELEVENLABS_API_KEY

2. 开始剪辑

  1. 创建一个文件夹,放入你的原始视频素材(.mp4, .mov 等)。
  2. 在终端进入该文件夹,启动 Claude Code:
    cd /path/to/your/videos
    claude
    
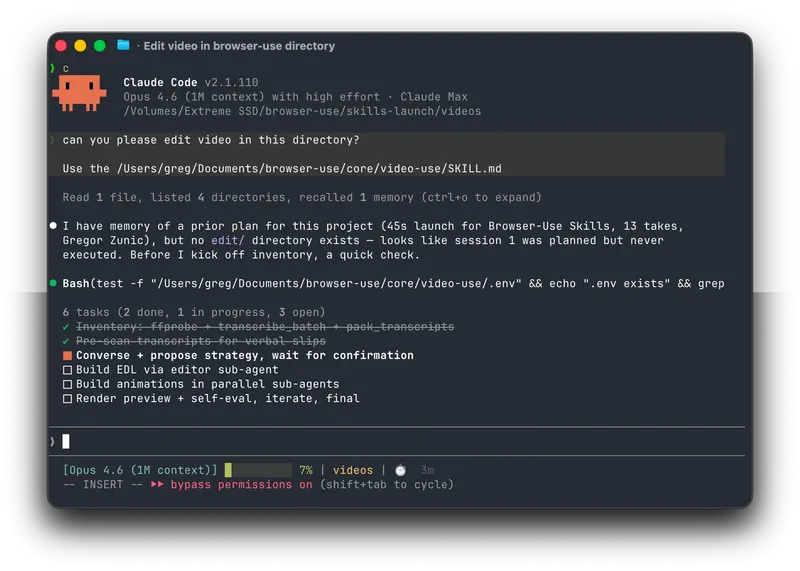
  3. 输入指令,例如:

    “把这些素材剪辑成一个关于产品发布的介绍视频。剪掉所有停顿和口头禅,加上动态字幕,使用电影感调色。”

  4. Claude Code 会:
    • 清点素材并生成转录摘要。
    • 提出剪辑策略并等待你确认。
    • 执行剪辑、渲染,并在 edit/final.mp4 输出成品。

工作原理详解

video-use 的核心在于将非结构化的视频数据转化为 LLM 可理解的结构化文本:

  1. Transcribe (转录):调用 ElevenLabs Scribe API,获取高精度的词级时间戳、说话人 ID 和音频事件标签。
  2. Pack (打包):将所有素材的转录信息压缩为一个轻量级的 Markdown 文件 (takes_packed.md)。这是 LLM 的“主视图”。
  3. LLM Reasons (推理):LLM 阅读文本,理解内容逻辑,决定保留哪些片段、删除哪些部分、在哪里添加特效。
  4. EDL (编辑决策列表):LLM 生成一个精确到毫秒的编辑列表。
  5. Render (渲染):使用 ffmpeg 根据 EDL 执行实际的剪辑、拼接、调色和字幕烧录。
  6. Self-Eval (自评):生成关键帧的 timeline_view,LLM 检查剪辑点是否平滑、字幕是否遮挡主体等。若不合格,返回步骤 3 修正。
设计哲学

  • 文本为主,视觉为辅:转录是表面,视觉校验是补充。拒绝暴力穷举帧。
  • 音频驱动剪辑:人类对话的节奏由音频决定,因此剪辑点优先遵循语音边界和静音间隙。
  • 零内容假设:不预设你是做访谈、教程还是旅行 Vlog。LLM 先观察素材,再制定策略。
  • 生产级正确性:遵循 12 条硬规则(如音频不爆音、字幕不越界),确保输出可直接发布。

相关导航