ClipProj-MiniMax-H3
MiniMax H3 的视频生成能力很强,但它的文本编码器(Qwen3-VL-32B)是个“显存杀手”,光这一项就要吃掉 15.7 GB 显存。ClipProj 提供了一个巧妙的解决方案:通过一个学习到的线性投影矩阵,让只有 40 亿参数的 Qwen3-VL-4B 也能产出符合 H3 要求的条件控制张量。
H3-Latent-Upscaler-2x
在处理 MiniMax H3 视频时,传统的放大流程是“VAE 解码 → 像素缩放 → VAE 重编码”,这不仅耗时,还会引入额外的画质损失。H3-Latent-Upscaler-2x 提供了一种纯隐空间的解决方案,它能直接将干净的视频隐空间映射到 2 倍大的空间网格上,全程不触碰像素域。
MiniMax-H3-Image-VAE
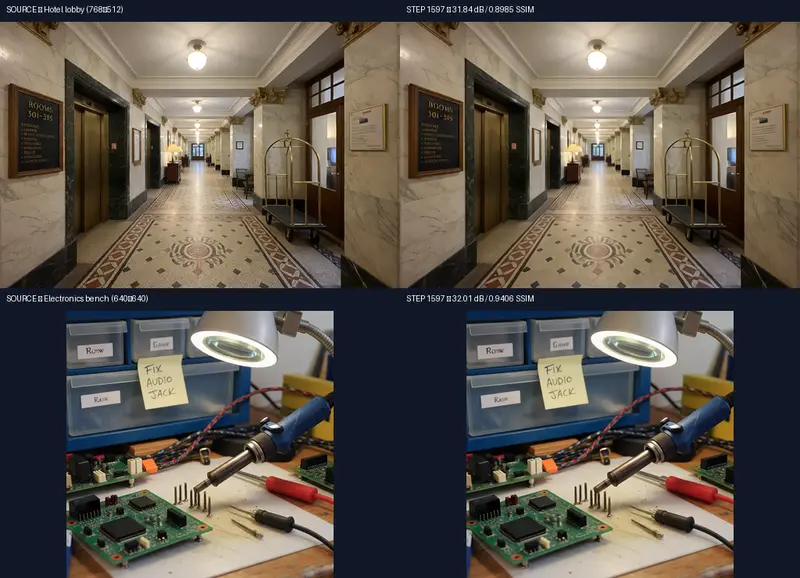
MiniMax H3 的默认 VAE 是为视频设计的,处理单张图像时往往需要凑够时间维度,流程比较繁琐。MiniMax H3 single-image VAE 是一个实验性的专用检查点,它能直接把单个时间步(T=1)的 H3 隐空间解码成一张完整的图片。
Minimax-H3-Turbo
Lightx2v团队发布Minimax-H3-Turbo,为MiniMax-H3模型提供推理加速能力。该LoRA支持4步快速生成,推荐配置为0.75强度搭配er_sde或sa_solver调度器。
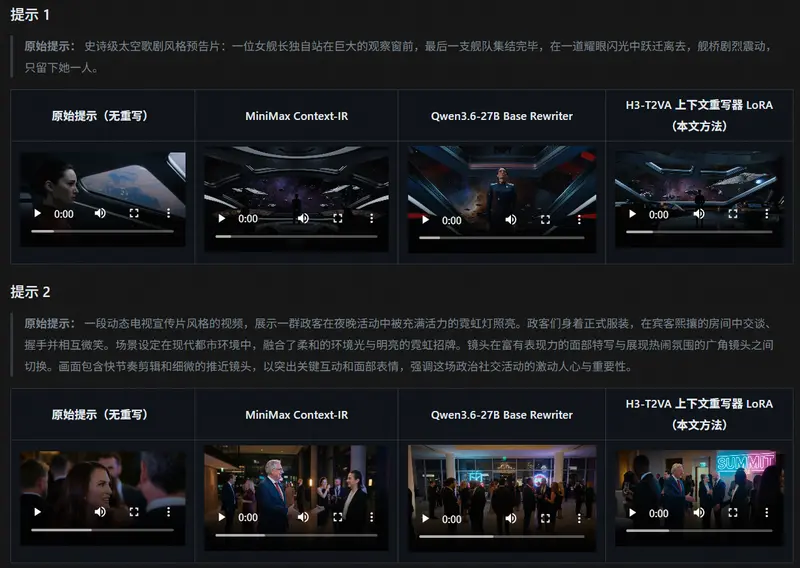
MiniMax-H3 T2VA Prompt Rewriter LoRA
lightx2v团队开源的MiniMax-H3 T2VA Prompt Rewriter LoRA是一款基于Qwen3.6-27B微调的LoRA适配器,专为将简短文本提示转换为MiniMax-H3文本生成音视频(T2VA)任务所需的结构化描述而设计。
MiniMax-H3 Turbo 4-Step — ComfyUI Pruned-Model LoRAs
此Lora由 larryvrh 创建的原始 MiniMax-H3 Turbo LoRA 的第三方 ComfyUI 兼容性转换版本,专为剪枝/曲线形态 MiniMax-H3 检查点设计。转换解决了原始权重张量键命名空间不匹配导致的加载失败问题,并包含两个进一步训练的 checkpoint-500 变体。所有文件均为部分兼容版本,保留核心注意力与MLP适配器,移除51对AdaLN投影以适配剪枝架构。
Qwen3-VL-32B Ultra Uncensored Heretic — MiniMax-H3 ComfyUI INT8 ConvRot
社区开发者推出了这款基于 Qwen3-VL-32B-Instruct-ultra-uncensored-heretic 定制的文本/视觉条件编码器。 该检查点经过深度裁剪与 INT8 ConvRot 量化,将原本超过 51 GB 的 BF16 模型压缩至约 24.55 GiB,使其能够在 RTX 5090 (32GB VRAM) 等高端消费级显卡上完成加载与推理,是运行 MiniMax-H3 的推荐版本。
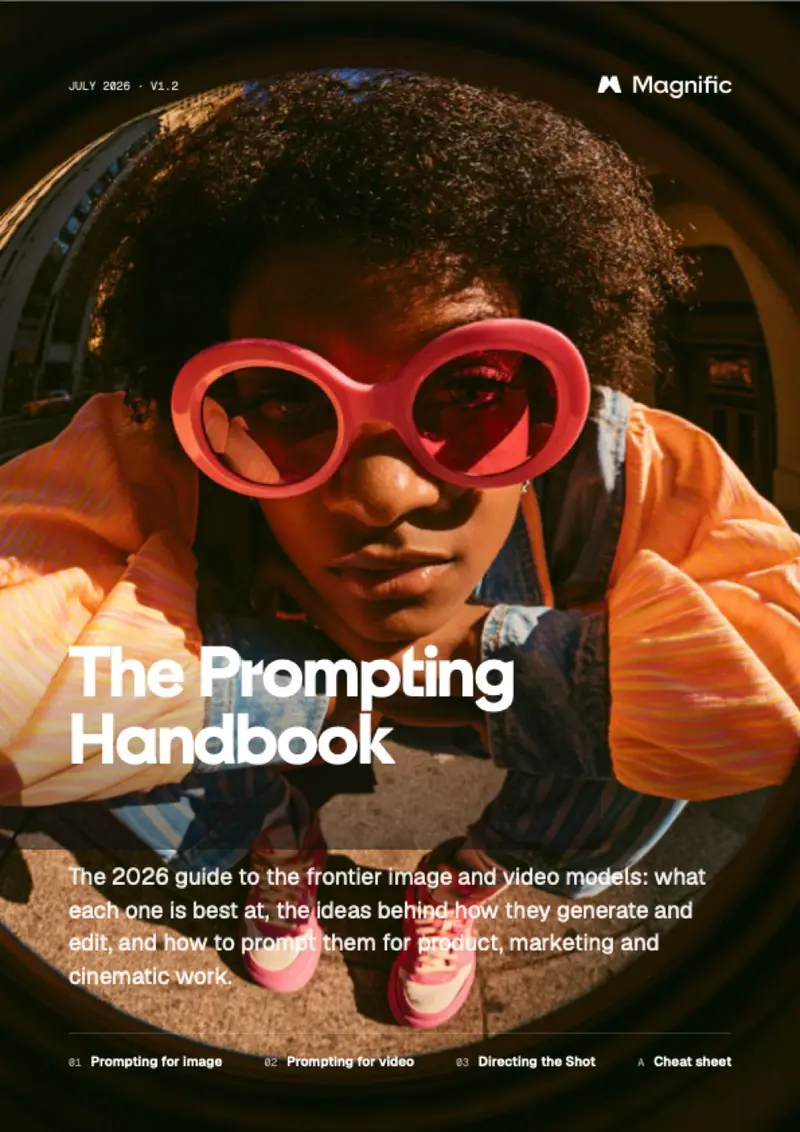
The Prompting Handbook
知名 AI 图像处理平台 Magnific 发布了一份长达 38 页的《2026 前沿图像与视频模型指南》。这份手册不仅是对当前主流模型的深度评测,更是一本教创作者如何用专业视觉语言“指挥”AI 的实战教科书。
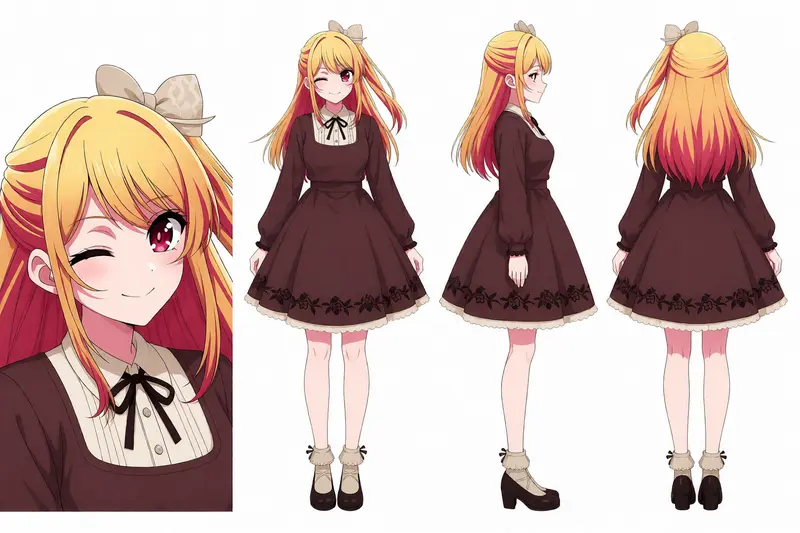
CharacterSheet
CharacterSheet 是一系列图像编辑 LoRA,可将现有角色图像转换为清晰的多视图参考图。这些模型旨在在生成的视图中保留角色的身份、服装、比例和整体外观。
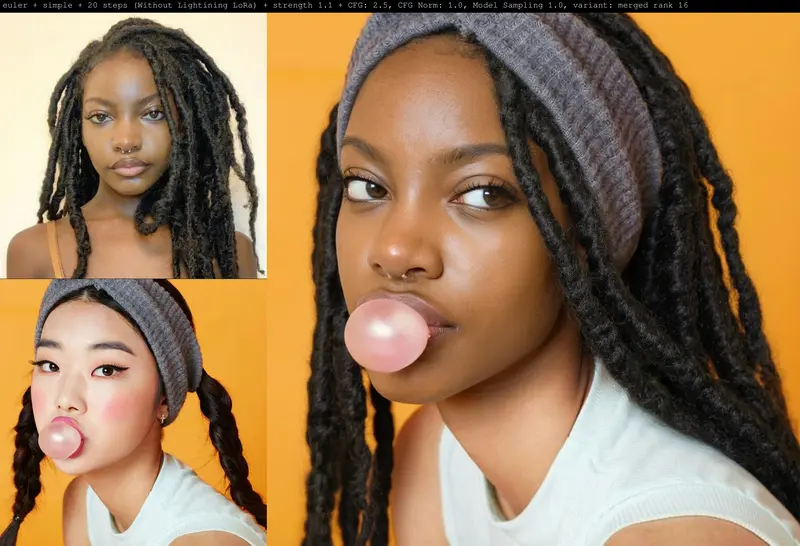
BFS (Best Face Swap)
BFS (Best Face Swap) 是一套专为 Qwen Image Edit (2509/2511) 和 Flux 2 Klein (4b/9b) 模型设计的 LoRA 集合。它旨在实现极高保真度的面部替换与完整的头部转移,同时确保肤色自然融合、光照一致以及解剖结构的合理性。
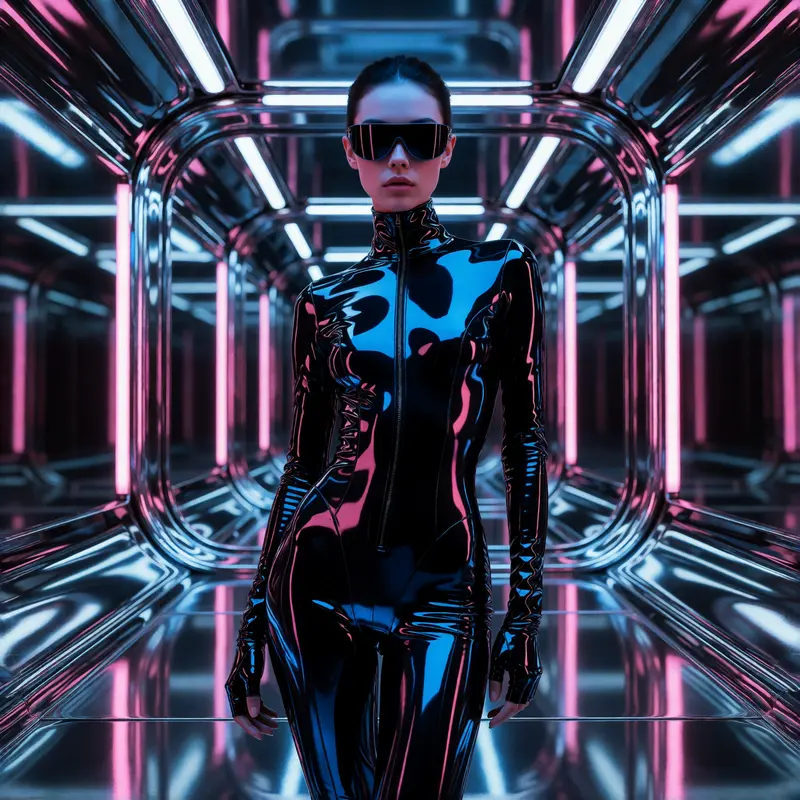
Kreamagine
Kreamagine 是一款基于 Krea-2-Turbo(12.9B 单流 DiT)进行风格适配的微调模型。它保留了基础模型 8 步生成的极速特性,但通过引入 Grok Imagine v0.9/v1.0 的数据集进行训练,显著增强了光照表现力与细节密度。
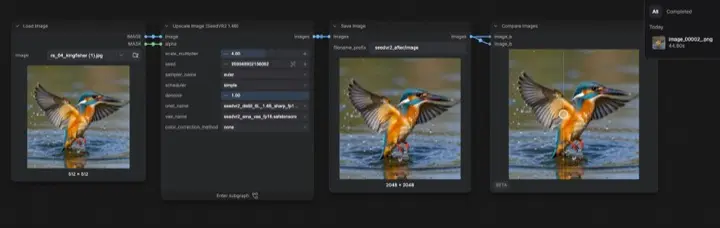
SeedVR2-1.4B
SeedVR2-1.4B 是SeedVR2-7B 教师模型的 6 层蒸馏版本。作为一个仅含 14.4 亿参数、6 个 Transformer 块的单步扩散模型,它专为解决 7B 模型在消费级硬件上“过大、过慢、不可用”的痛点而生。
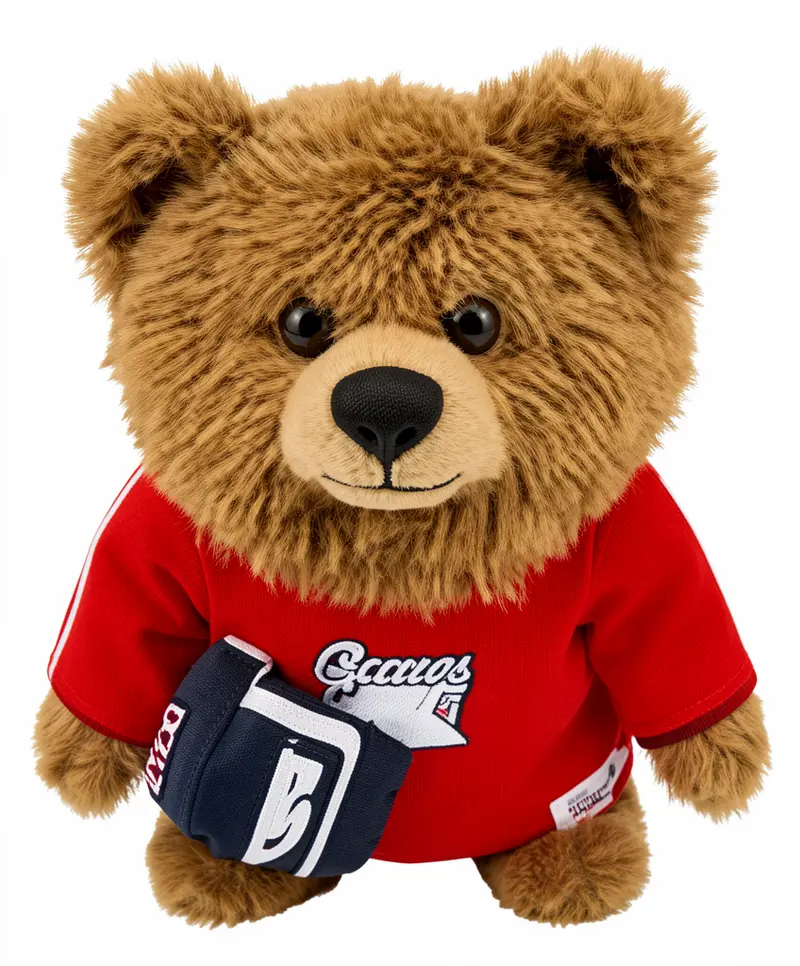
Edit Anything
Edit Anything 是一组基于 LTX-2.3 模型构建的实验性 LoRA,旨在探索视频内容的精细化编辑能力。该套件包含三个独立的训练轨迹,分别针对运动迁移、无参考多任务编辑以及参考图像驱动的视频到视频转换。
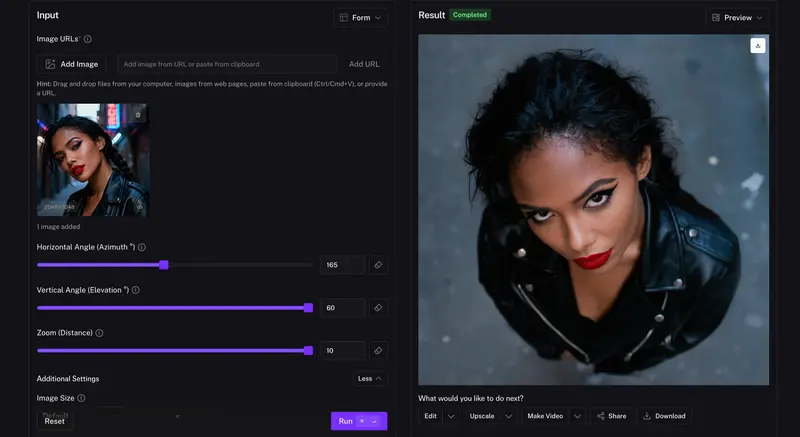
Flux 2 Multi-Angles LoRA v2
Flux 2 Multi-Angles LoRA v2 是一个Leon1000与 fal.ai 合作训练的高质量 LoRA 模型,专为 FLUX.2-dev 基础模型设计。它通过引入标准化的提示词标签,让用户能够以极高的精度控制生成图像的相机角度、仰角和景别,彻底告别“抽卡式”运镜。
创始人行动手册
Anthropic 正式发布 《The Founder's Playbook》(创始人行动手册)。这不是一份泛泛而谈的趋势报告,而是一套专为 AI 原生创业 设计的实操指南。它将创业旅程拆解为 构想(Idea)、MVP、上线(Launch)、规模化(Scale) 四个阶段,并结合 Claude 系列工具,提供了明确的目标、退出标准及避坑指南。
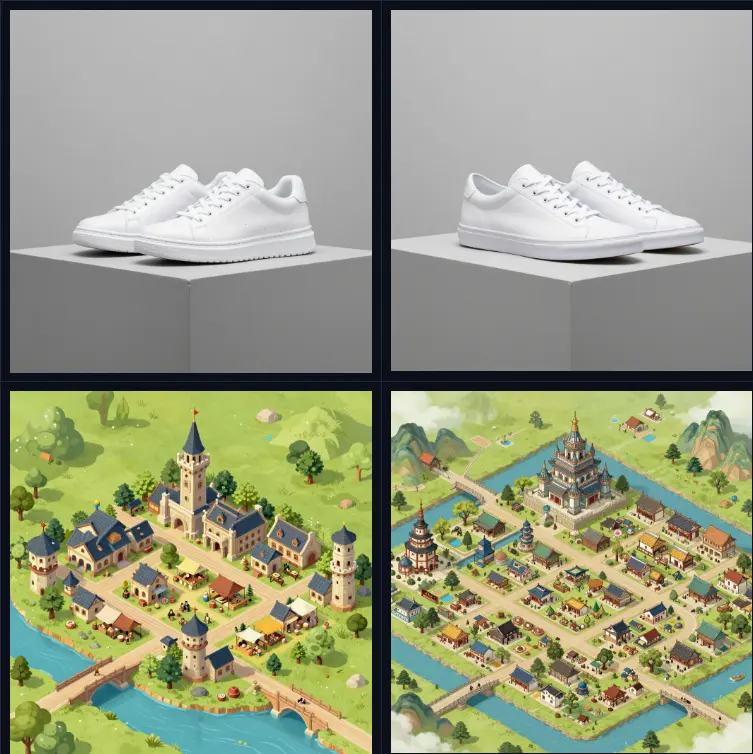
Z-Image-Turbo Student Adapter
Z-Image-Turbo Student Adapter 通过一种巧妙的文本编码器蒸馏技术,将原始的 4B 参数编码器替换为更轻量的 1.7B 学生模型加上一个微型适配器。
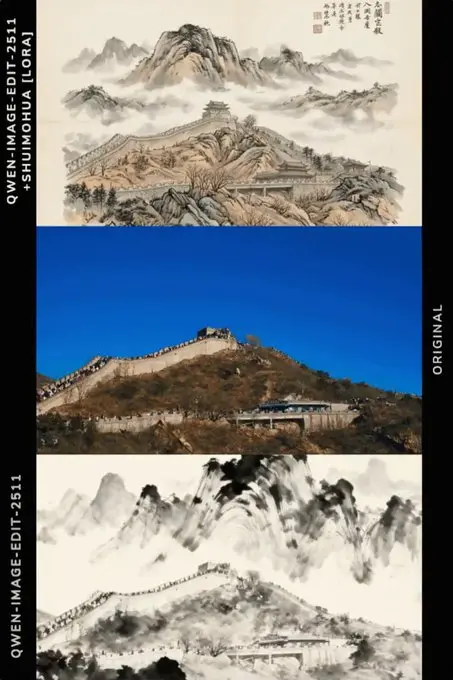
shuimohua(山水画)
shuimohua(山水画)是一个Qwen-Image-Edit-2511的lora,可以将真实的风景转换为经过精心描绘而成的山水画杰作。现代摄影与古老艺术风格的完美融合。
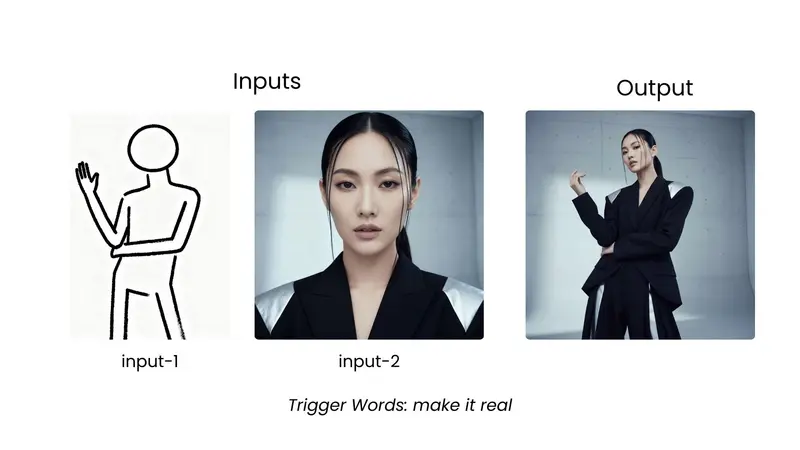
Draw2Photo
Draw2Photo LoRA 是一款基于 Qwen-Image-Edit-2511 模型的Lora,这款 LoRA 能够将一张简单的儿童素描与一张真实的人脸照片结合,生成一张既保留画作创意结构、又拥有逼真质感和人物身份的高清照片。