Coucou - 最新版
Coucou 是一款开源桌面小助手,自带可爱角色Mochi。Mac上它栖身在刘海/灵动岛区域;Windows、Linux则固定在屏幕顶部边缘,专门用来监视AI编码智能体会话。
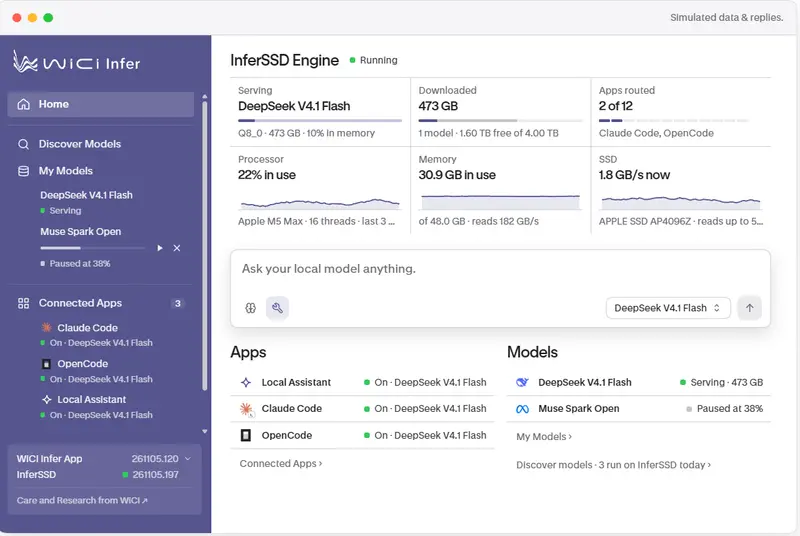
在大语言模型(LLM)参数规模日益膨胀的今天,显存(VRAM)和内存(RAM)容量往往成为本地部署的最大瓶颈。InferSSD 作为一个开源的本地大模型推理项目,提出了一种颠覆性的解决方案:利用高速 SSD 作为“扩展显存”,直接驱动混合专家(MoE)模型的推理过程。基于 llama.cpp 构建,InferSSD 允许用户在物理内存远小于模型体积的消费级设备上,流畅运行如 DeepSeek-V4.1-Flash-1017(763B 总参数)等超大模型,并提供浏览器聊天界面及 OpenAI 兼容 API。
传统推理框架通常要求将模型权重全部加载至内存或显存中。InferSSD 则针对 MoE 架构的特性进行了深度优化:
InferSSD 已针对多款主流超大参数 MoE 模型进行了测试与优化:
| 模型名称 | 总参数量 | 活跃参数 | 推荐 GGUF 版本 | 备注 |
|---|---|---|---|---|
| DeepSeek-V4.1-Flash-1017 | 763B | 8–16B | Q8_0 (mrfakename) | 保持官方位宽,路由专家为原生 4 位 MXFP4 |
| Muse-Spark-Open | 816B | 42B | UD-Q4_K_XL (Unsloth) | 专为 SSD 卸载优化 |
| Qwen3.6-35B-A3B | 35B | 3B | UD-Q4_K_XL (Unsloth) | 轻量级 MoE |
| Qwen3.8 Flash Next | 177B | A3B | IQ4_XS (Bartowski) | 高效推理 variant |
| Gemma4 E4B | 7.46B | E4B | QAT Q4_0 (Google) | 使用普通 RAM 推理,无 SSD 卸载 |
在与 llama.cpp 和 Colibri 的对比测试中,InferSSD 在预填充和解码阶段均展现出巨大的速度优势,尤其是在显存受限的设备上。以下是 DeepSeek-V4.1-Flash-1017 在部分硬件上的解码速度(Token/s)对比:
| 硬件平台 | LLAMA.CPP | COLIBRI | INFERSSD | 加速比 (vs llama.cpp) |
|---|---|---|---|---|
| MacBook Pro (M5 Max, 48GB) | 0.873 | 0.437 | 2.874 | 3.29× |
| RTX 5060 Ti (8GB VRAM) | 0.242 | 0.900 | 2.550 | 10.54× |
| RTX 5090 (32GB VRAM) | 0.867 | 1.878 | 7.270 | 8.39× |
| DGX Spark (128GB Unified) | 1.608 | 0.356 | 7.260 | 4.51× |
注:在 RTX 5060 Ti 等小显存设备上,InferSSD 的性能提升尤为惊人,因为它避免了因显存不足导致的频繁交换或无法运行的问题。
InferSSD 提供了极简的安装体验,支持 macOS (Apple Silicon)、Windows 11 x64 及 Linux (NVIDIA GPU)。
macOS / Windows (预构建包):
curl -fsSL https://github.com/wici-ai/inferssd/releases/latest/download/install.sh | sh
Linux 用户需从源码构建,确保已安装 Git, Python 3.9+, C/C++ 编译器及 CUDA Toolkit。
安装完成后,可通过命令行直接启动聊天或 API 服务。以下以 DeepSeek-V4.1 为例:
启动 CLI 聊天:
inferssd cli -hf mrfakename/DeepSeek-V4.1-Flash-1017-GGUF
启动 Web UI 及 OpenAI 兼容 API:
inferssd serve -hf mrfakename/DeepSeek-V4.1-Flash-1017-GGUF
启动后,访问 http://127.0.0.1:8080 即可在浏览器中体验,或通过 http://127.0.0.1:8080/v1 接入其他兼容 OpenAI 协议的客户端。
~/.local/share/inferssd/models。--model-dir 指定 SSD 存储路径,或使用 -m 指向本地已有的 GGUF 分片文件。InferSSD 采用严格的版本控制,每个构建包含日期、提交计数及 Commit Hash(如 261106.202.03af979)。用户可以通过 inferssd --version 查看当前版本及支持的 GPU 后端能力。对于 macOS 和 Windows 用户,安装包会携带对应的元数据,便于桌面应用进行增量更新。