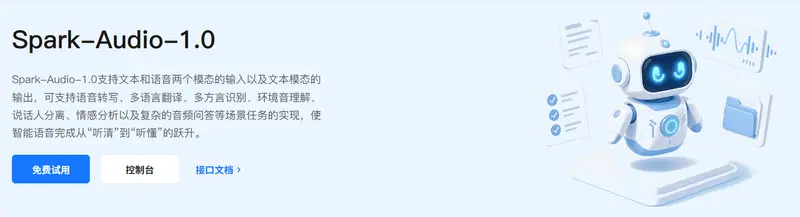
科大讯飞今日宣布,其新一代语音基座大模型 SparkAudio 1.0 正式在讯飞开放平台上线 API 服务。该模型突破了传统“语音转文字+文本大模型”的级联架构限制,实现了从原始音频到语义理解的端到端处理,支持文本与语音双模态输入及文本输出,旨在解决复杂场景下的音频信息丢失与链路延迟问题。
- 体验链接:https://iflytekresearch.iflytek.com/console/spark-audio
- API 地址:https://www.xfyun.cn/services/Spark_Audio_1.0
技术范式转变:从“听写”到“听懂”
传统音频处理方案通常采用级联模式:先通过 ASR(自动语音识别)将语音转换为文本,再交由 LLM(大语言模型)进行理解。科大讯飞指出,这种模式存在两大核心短板:
- 高维信息丢失:文本仅保留字面内容,丢失了语气、情绪、背景环境音等非语言线索,导致模型对场景上下文的理解不完整。
- 链路割裂与误差累积:ASR、声纹识别、翻译等模块独立运行,不仅增加了系统延迟,还容易因上游模块的错误导致下游任务性能下降。
SparkAudio 1.0 采用端到端架构,直接对原始音频波形或特征进行建模。它能够一次性处理人声、环境音及音乐,同步解析声音中的语义、情感状态及物理场景,实现了真正的“全模态音频理解”。
核心能力升级
相较于上一代模型,SparkAudio 1.0 在覆盖广度、理解深度及基础设施自主性方面进行了显著升级:
| 升级维度 | 具体表现 |
|---|---|
| 听见更多 (多语言/方言) | 支持 99 种语言 和 202 种方言 的识别与翻译,具备极强的多语言混合处理能力。 |
| 理解更透 (多维音频理解) | 超越单纯的文字转录,支持说话人分离、情感分析、环境音理解及复杂音频问答。能够捕捉深层语义与场景线索。 |
| 用得更广 (自主可控) | 基于全国产算力训练而成,为行业应用提供安全、自主可控的语音智能底座。 |
应用场景拓展
凭借对音频全要素的理解能力,SparkAudio 1.0 适用于对实时性、准确性和场景感知要求极高的领域:
- 智能客服与质检:通过情感分析和说话人分离,精准判断用户情绪波动及对话角色,提升服务针对性。
- 汽车智能座舱:结合环境音理解(如车窗噪音、音乐背景),在嘈杂环境下实现更自然的语音交互。
- 跨语言会议助理:支持多方言、多语言的实时转写与翻译,并保留发言人的语气特征。
- 医疗病历生成:准确区分医生与患者对话,捕捉问诊过程中的关键语气与非语言线索。
- 内容安全审核:识别音频中的敏感环境音、特殊语气及隐含语义,弥补纯文本审核的盲区。
目前,开发者可通过讯飞开放平台直接调用 SparkAudio 1.0 的 API,将其集成至各类音频处理应用中。这一发布标志着科大讯飞在语音大模型领域从“工具型识别”向“认知型理解”迈出了关键一步。
© 版权声明
文章版权归作者所有,未经允许请勿转载。