OpenAI音频模型
OpenAI正式推出了全新的音频模型,涵盖了文本转语音(Text-to-Speech, TTS)和语音转文本(Speech-to-Text, STT)两大核心功能,为语音交互领域带来了重大突破。
 rss-pod
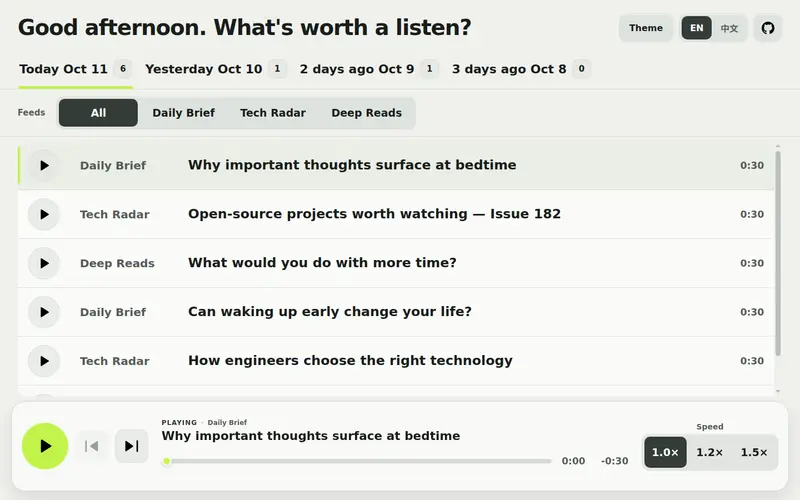
 是一款开源自托管应用,核心定位是把来不及阅读的 RSS 订阅内容,自动整理成多人对话文稿,再合成语音音频,同时提供网页播放器与标准播客 RSS 订阅链接,方便在通勤、散步时收听。
它支持原生RSS、派生RSS源,还可以接入 Jina、Crawl4AI 展开抓取网页正文;LLM 支持多服务顺序降级兜底,并且可以在生成音频前配置内容过滤,过滤低质、营销类内容。语音合成支持 Edge TTS、Azure Speech、Azure MultiTalker,可自定义对话角色与音色。
存储架构上,采用 PostgreSQL + River 维护任务进度,支持自动重试、断点续跑;原文、对话脚本、音频文件统一存入 S3 / MinIO 对象存储。程序分发非常轻量化,单 Go 二进制文件或者 Docker 容器即可运行,同时内置中英双语网页播放器,可选管理员后台。
需要提前准备 PostgreSQL、兼容 S3 的对象存储、至少一个兼容 OpenAI 协议的 LLM 服务,以及 Edge TTS 或 Azure Speech 语音服务。
config.example.yaml、.env.example,填写数据库、对象存储、LLM 凭据;预先创建 rsspod-private、rsspod-media 两个存储桶,媒体地址需要可公开访问。poll 命令手动触发单源抓取生成,后续依靠 cron 定时自动拉取,中断任务支持 resume-incomplete 断点恢复,复用已经生成的素材。run 同时启动网页+调度+队列;serve 仅网页管理;worker 只跑任务队列,适合分布式部署;业务播放器端口 8080;健康检查、任务管理接口监听 127.0.0.1:8081,严禁直接对公网暴露;公网部署必须套 HTTPS 反向代理。管理员后台依赖 TOTP,服务器时间必须保持同步;音频直链一旦分发,隐藏节目不会撤回已缓存音频。