zoetrope
zoetrope 是一款开源工具,旨在以直观的动态流程图形式,实时展示 Claude Code 的会话过程。它通过读取 Claude Code 在本地生成的 JSONL 转录文件,将复杂的代理交互、子代理生成及工具调用转化为清晰的视觉图表。
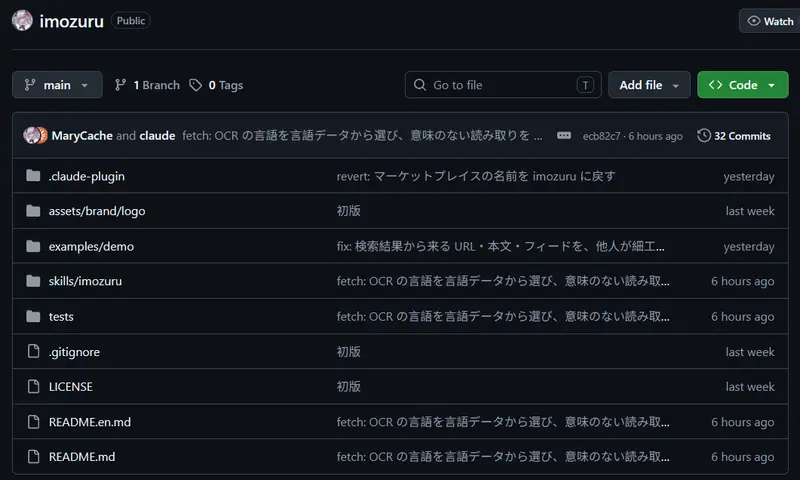
 imozuru
 是一款专为 Claude Code 设计的深度信息搜寻技能(Skill)。其名称源自日语习语“芋づる式”(顺藤摸瓜),旨在通过一条线索接一条线索的追踪,帮助用户在陌生领域中直达原始信息来源。该工具深度应用了图书馆与信息科学中的经典理论,如 Bates 的“采莓”(berrypicking)模型、Ellis 的信息搜寻行为模型以及 Kuhlthau 的信息搜索过程理论。
传统的 LLM 搜索通常会抓取前几个搜索结果并直接生成摘要。这种方式虽然快捷,但往往会丢失判断细节所需的关键上下文。此外,当用户不熟悉某个领域的专业术语时,很难提供精准的搜索词,导致搜索结果始终停留在表层。
imozuru 改变了这一范式。它不直接生成摘要,而是首先识别该领域的专业术语、核心人物和知识聚集地,然后顺藤摸瓜地追踪引用、链接和作者,直至找到原始来源。它会将这些来源原样保存,并精确指出“哪个文件、哪些行”支撑了特定的论点,将最终的阅读与判断权交还给用户。
map.md)。sources/ 目录中。404 页面或需要登录的付费墙页面在检查内容后会被自动丢弃。此外,imozuru 还支持监视模式(watch),可通过 RSS 持续从首次挖掘发现的场所(如 Qiita、Zenn、note、YouTube、博客或 arXiv)收集最新帖子。
[Paper](同行评审或预印本)、[First-hand](第一手实践记录)、[Observation](观察笔记)、[Roundup](综述)或 [Official](官方文档),由用户自行判断可信度。imozuru 可作为 Claude Code 插件安装(/plugin marketplace add MaryCache/imozuru),或通过 skills CLI 安装(npx skills add MaryCache/imozuru)。
脚本基于 Python 3.10+ 标准库运行,但为了实现完整功能,系统需安装以下外部工具:
pdftotext / pdftoppm (poppler 或 Xpdf):用于提取 PDF 文本或对无文本层的旧 PDF 进行 OCR。tesseract (含 jpn 和 jpn_vert 语言数据):用于读取日语扫描件(横向与纵向)。yt-dlp:用于下载 YouTube 视频字幕。ax:用于将 HTML 更好地转换为 Markdown(保留标题和表格结构)。执行研究后,结果将保存在 ~/research/<topic>/ 目录下:
map.md:问题、所需声称、术语、人物、场所、来源表及下一步线索。log.md:每轮搜索的记录,包括搜索内容、发现、决策及其原因。sources/:保存的原始来源文件。extracts.json:结构化摘录数据。report.html:可视化的摘录页面,供最终审查。IMOZURU_ALLOW_PRIVATE=1 关闭此检查。