MiniMax-MCP
MiniMax 的 MCP 服务器为开发者提供了一个强大且灵活的工具,帮助您快速构建支持语音、视频和图像生成的智能应用。无论是个人创作者还是企业开发者,都可以通过简单的配置,将 MiniMax 的 AI 能力无缝集成到您的项目中。
 earshot
 核心定位是给编程智能体装上耳朵。当前AI编程智能体可以渲染影片、游戏、演示画面,但无法感知音频细节,分不清按键音色、听不出音效同步偏差。
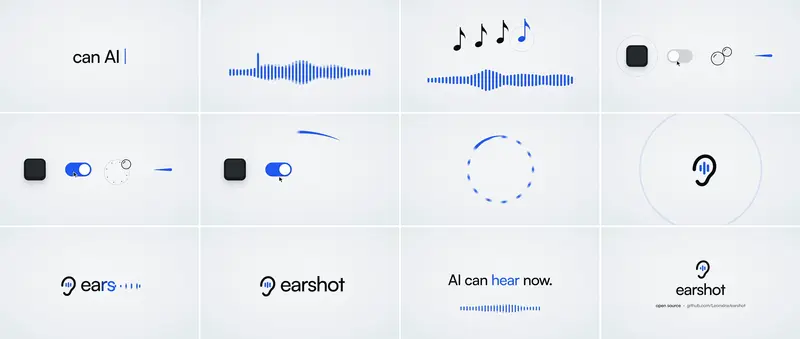
earshot 将音频转换成编程智能体能够读懂、推理的结构化证据,全程CPU本地运行,提供CLI、Python API、MCP服务器三种接入方式,可直接对接Claude Code等AI编程智能体。
| 命令 | 作用说明 |
|---|---|
| describe | 输出音频文字描述、AudioSet标签、声学测量与置信度分数 |
| match | 判断音频和文本描述的匹配程度,输出裁决与证据 |
| rank | 批量音频按文本描述相关性排序 |
| find | 在长音频内定位符合描述的片段,输出起止时间戳 |
| compare / ab | 对比两段音频差异,也可对照参考录音评估典型性 |
| realness | 区分音频是真实录音还是代码合成,给出逐段分数 |
| timeline | 生成逐秒音频时间线,包含事件、响度、节拍、音画同步信息,支持绑定视频 |
| sheet | 输出带波形、频谱、事件标记的注释PNG,供看图型AI编程智能体读取 |
| critique | 专业影片音轨评分卡,定位问题并给出带时间戳的修复建议 |
| profile | 从参考影片生成自定义评估配置文件 |
| measure | 纯客观声学测量:LUFS、峰值、包络、频谱等,不依赖大模型 |
| forge | 根据配方代码渲染音效,自动迭代优化,无需原始音频采样 |
| fit | 把一段真实录音反向拟合为合成代码配方,支持参数变形、声音插值 |
| gallery | 导出静态HTML画廊页面,内置播放器、频谱图、指标,方便浏览合成音效 |
| mcp | 启动MCP服务,让Claude Code等编程智能体直接调用全套音频能力 |
CLI单次调用会重新加载模型(耗时20–40秒),高频调用建议使用MCP服务长驻加载模型,或直接调用Python API。
earshot forge 是物理建模音效合成器,不靠预存音频采样,依靠模态谐振、噪声、房间声学、麦克风模拟等DSP组件渲染声音。
工作流程:编程智能体编写音效配方,工具批量渲染候选样本,通过多维度评估(文本匹配度、真实感、频谱包络、失真、瞬态/衰减特征),使用进化搜索迭代调参;编程智能体读取critique报告,修改配方,反复迭代直到音效达标。
内置34类运动音效配方:呼啸、撞击、低频Drop、UI点击、按键、提示音、故障音效等,v2版本改进了声音衰减、频谱平衡,盲测中人很难区分合成音效与真实录音。
earshot forge keypress --refs path/to/real/keypresses/ --budget 144 --variants 4 --dir made/keypress
earshot fit 对真实录音做逆向分析,拟合分层声学模型,输出可编辑的Python合成配方。配方存储声学结构而非音频采样,可以调整时长、音高、阻尼、亮度,还能在两段声音之间做变形插值。
在12组测试录音实验中,原始录音与代码渲染结果的中位CLAP余弦相似度0.945,盲听测试听众无法分辨。
内置183个forge v2成品音效,支持通过代码实时渲染,无模型、无需联网。支持自定义音效套件(kit),为项目内各类交互事件绑定音效,自动做音频审计,检测削波、伪影、异常振铃等问题。可精确控制峰值位置、音高、时长,误差控制在毫秒级。
git clone https://github.com/Leonxlnx/earshot && cd earshot
python -m venv .venv
.venv/bin/python -m pip install torch --index-url https://download.pytorch.org/whl/cpu
.venv/bin/python -m pip install -e ".[mcp,llm,dev]"
.venv/bin/python -m earshot doctor --load
claude mcp add earshot --scope user -e EARSHOT_THREADS=3 -- /path/to/earshot/.venv/bin/python -m earshot mcp
earshot适合评估响度、时序、音画同步、声音类别;不擅长判断音乐情绪、艺术品味、版权许可。高复杂度混音环境下,声音标签识别可靠性下降;模型存在被优化“欺骗”的可能,不能单靠模型分数,必须结合客观声学测量、频谱图与人工盲测综合评估。