Codex with ChatGPT
Codex with ChatGPT 是一个创新的桥接工具,解决 ChatGPT 网页版额度闲置 与 Codex API 额度紧张 之间的矛盾。它通过将“规划与审查”交给已付费的 ChatGPT 网页版,而将“代码执行”保留在 Codex 手中,实现了算力资源的最优配置。
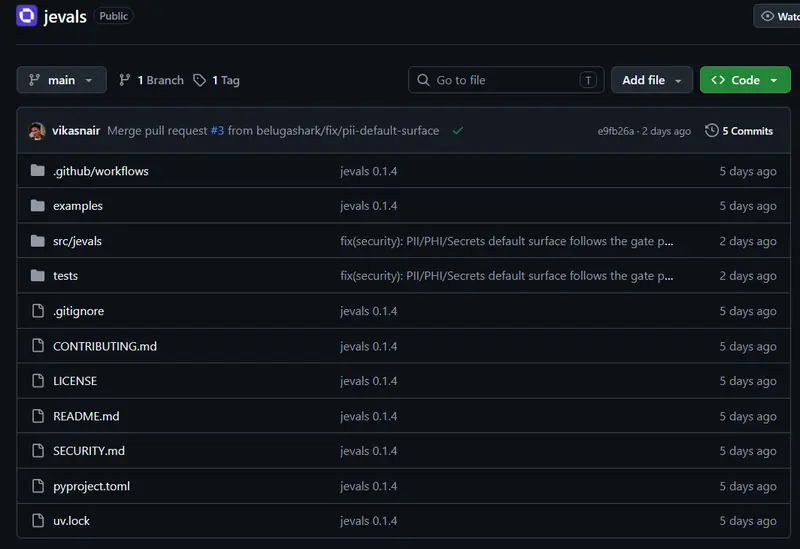
 jevals
 是一套面向AI智能体的评估与防护Python库,核心思路是使用Jev这类决策模型,替代传统生成式大模型(LLM)作为评判器。一次请求即可完成一条Agent全链路追踪(trace)的多项检测,成本仅千分之几美分,响应时间几百毫秒,因此可以嵌入Agent主循环,在每一次执行轨迹上实时运行评估。
它支持多种后端:TypeSafe / Vercel网关接入Jev;本地Mac运行Kev、Laya;也可以兼容普通聊天LLM作为模拟后端(缺点是速度慢、成本更高)。
pip install jevals
# 启用PII/PHI实体识别
pip install "jevals[pii]"
# MCP服务,Cursor / Claude Code 可调用jevals编写评估规则
pip install "jevals[mcp]"
# Apple Silicon本地Laya离线推理
pip install "jevals[laya]"
传统评测库(Ragas)依赖LLM生成JSON、大量few-shot示例,单个样本往往需要6~11次模型往返,耗时数秒,成本高。生产环境只能抽样少量日志做离线评估,无法在Agent执行过程中实时校验。
并且LLM评判器结果方差巨大,LangChain测试显示,同一条Agent轨迹,GPT/Claude评判分数波动幅度是Jev的92~913倍,不稳定的评判很难作为测试套件。
Jev决策模型不生成文本:传入状态与一组结构化问题(二分类、选项选择、打分标尺),单次前向运算输出校准后的概率;多个评估问题并行处理,增加检测项几乎不会增加延迟,只会小幅增加输入token。计费仅收取输入token,无输出token费用。
jevals把评测拆成两部分:普通文本处理交给代码(句子拆分、正则密钥扫描、Presidio实体识别);主观判断交给决策模型。同一套评估定义,既能离线批量跑数据集指标,又能上线作为运行时安全护栏,保证离线评估与生产防护标准完全一致,不会出现规则漂移。
隐私检测采用“实体预识别+模型二次判断”,减少单纯实体识别带来的大量假阳性。
Gate = 评估规则 + 策略,输出 allow / escalate / block 三种结果。支持Python代码或YAML声明式编写策略,可配置阈值、错误兜底策略。
典型场景:支持Agent在调用高危工具(退款、删数据、SQL写入、发送邮件)执行前拦截或升级人工审核;在工具返回结果后检测间接注入、脱敏PHI隐私。
示例逻辑:只读查询订单直接放行;退款、删除数据这类不可逆操作,自动升级人工复核;若工具返回内容包含劫持指令,则直接阻断。
evaluate() / 异步aevaluate()接口jevals calibrate labeled/tool_calls.jsonl --eval evals/tool_call_risk.yaml --label human_decision
使用人工标注数据自动扫描阈值,权衡误放行与误拦截,输出AUROC、Brier分数等指标,方便业务选定适合的风险阈值。
决策模型并非万能,适合做选项选择、是/否判断、分级打分;复杂多步数学推理、世界知识类任务,建议路由至LLM后端。更换后端后,概率分布会变化,必须重新执行calibrate校准阈值。
后端服务故障时,默认放行;高风险操作建议配置on_error="block",故障时直接阻断,防止风险逃逸。