中文互联网语料资源平台

1个月前发布 56 00

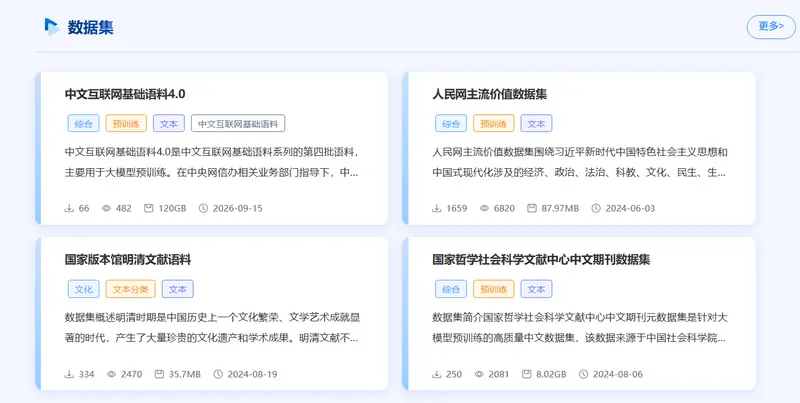
中文互联网基础语料 4.0 正式向社会发布,该数据集总量达 120GB,并已在“中文互联网语料资源平台”上线,供符合条件的机构和个人申请使用。
所在地:
中国
收录时间:
2026-09-16
中文互联网语料资源平台中文互联网语料资源平台

9 月 15 日下午,在济南召开的 2026 年国家网络安全宣传周人工智能安全治理分论坛上,中文互联网基础语料 4.0 正式向社会发布。该数据集总量达 120GB,并已在“中文互联网语料资源平台”上线,供符合条件的机构和个人申请使用。
中文互联网语料资源平台

核心亮点

  1. 权威指导与多方共建
    • 在 中央网信办 指导下,由 中国网络空间安全协会 联合 国家互联网应急中心 牵头。
    • 汇聚了 百度、中科闻歌、开普云、拓尔思、科大讯飞、知乎 等国内头部科技企业及内容平台的力量,依托网安协会人工智能安全治理专委会建立的语料共建共享机制共同完成。
  2. 高质量与可信性
    • 在前期发布的 1.0、2.0 和 3.0 版本基础上,进一步汇聚了一批新的高质量可信数据。
    • 经过一系列严格细致的数据加工处理措施(如去重、清洗、隐私脱敏、合规审查等),确保数据的纯净度与安全性,为大模型训练提供“干净”的燃料。
  3. 规模升级
    • 数据量达到 120GB,相比前几个版本有显著增长,覆盖了更广泛的中文互联网领域,包括新闻资讯、百科知识、专业文献、社交媒体讨论等。

如何获取?

用户可通过以下步骤获取数据:

  1. 登录 中国网络空间安全协会官网。
  2. 点击 “中文互联网语料资源平台” 链接。
  3. 完成 注册、认证 等程序后,即可下载或联系获取相关数据。

意义

  • 筑牢数据底座:中文互联网基础语料 4.0 的发布,是社会各界协同共建高质量中文语料的重要阶段性成果,进一步丰富了国内高质量中文语料供给体系。
  • 解决数据荒与数据毒:随着大模型对数据质量和数量要求的提高,公开、合规、高质量的中文语料成为稀缺资源。该语料库有助于缓解国内 AI 企业面临的“数据荒”,同时通过严格的治理机制减少“数据毒”对模型价值观和安全性的负面影响。
  • 持续迭代:网安协会表示,下一步将继续联合相关单位,联动各行业领域深化中文互联网基础语料建设,持续为人工智能产业高质量发展筑牢数据底座。

这一举措标志着中国在构建自主可控、安全可信的 AI 数据基础设施方面迈出了坚实的一步,对于提升国产大模型的竞争力和安全性具有深远意义。
相关导航