2026 年 9 月 8 日,智象未来正式在全球上线其核心产品 vivago R1,国内版本「够搭」同步完成全新升级。作为今年 7 月在 WAIC 2026 首次亮相的明星产品,R1 标志着 AI 视频创作从短暂的“片段生成”迈向了完整的“作品交付”新范式。

核心突破:从 15 秒到无限时长
与 Sora 等主流模型局限于 15-30 秒的片段式生成不同,vivago R1 能够一次性稳定输出长达 5 分钟的高质量视频,并支持通过多轮对话无限延长时长。
- 长视频叙事一致性:R1 解决了长视频中角色形象、场景风格和叙事节奏难以保持统一的痛点。
- Agent 系统调度:通过主 Agent 拆解创意,子 Agent 协同处理脚本、分镜、角色、场景与音效,确保多镜头、多角色、多场景下的逻辑连贯。
- 高成功率:依托自研 HD-AgentOS,内容有效可用成功率提升至 85%,显著降低了传统 AI 视频生成的“抽卡”不确定性。
- 实拍质感:优化了跨镜头角色一致性和场景过渡,弱化了 AI 视频常见的“塑料感”和“瞬移感”,实现更自然的运镜衔接与音画对齐。
Chat-First:让创作回归表达本能
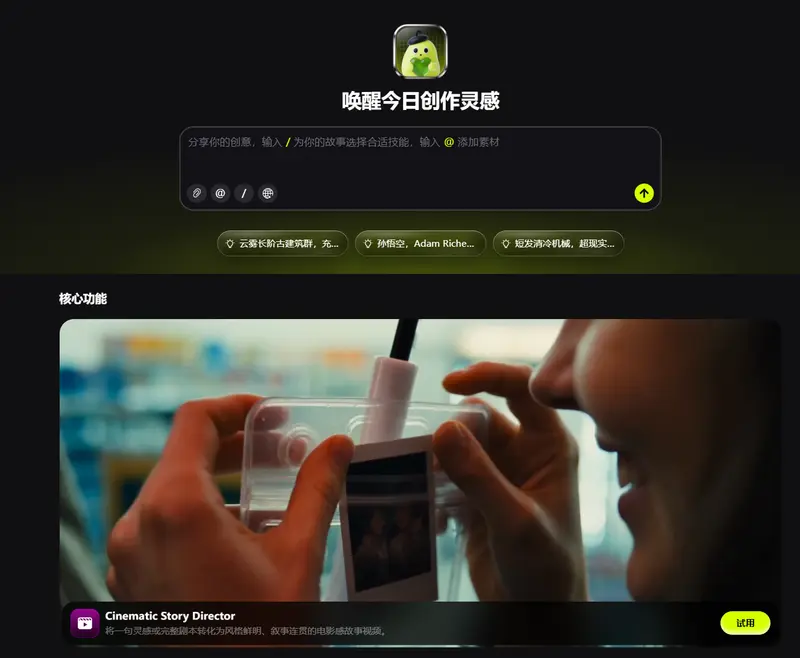
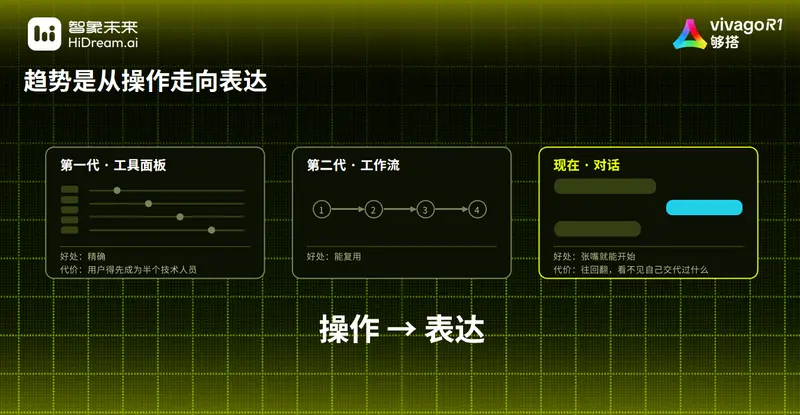
R1 摒弃了复杂的节点式或画布式工作流,采用 Chat-First(对话优先) 的设计路线:
- 自然语言交互:用户只需通过自然语言描述需求,即可启动创作。
- “做后”与“做厚”:
- 做后:将专业创作者的审美、判断和经验编码进 Agent 的中后台能力中。
- 做厚:构建 SkillHub,将抽象的 AI 能力转译为具体的创作场景(如产品广告、角色视频、故事短片),让用户直观理解如何开始。
- 意图转化:SkillHub 作为翻译层,自动匹配并编排所需的 Skill 组合,将用户的简单指令转化为可执行的任务序列。
理念:不是消灭复杂,而是把复杂藏在简单背后。从灵感到执行,缩短为“一句话”。
原生全模态架构:项目制创作与资产复用
为了解决长期创作中的一致性难题,R1 采用了“基础模型 + 智能体”双轮驱动策略:
- 原生全模态世界模型:能够同时理解文本、图片、视频、参考资产、文档说明及历史结果,让 Agent 掌握“任务全貌”。
- 智能体流程调度:负责在脚本、分镜、角色、场景、镜头和音效之间进行规划,确保声音特征和视觉风格在整个项目中前后一致。
- 资产库功能:沉淀用户生成并认可的内容,可在后续创作中复用,使每一次创作都成为下一次的基础,实现真正的“项目制”工作流。
CHATS™:视频 Agent 的新交付标准
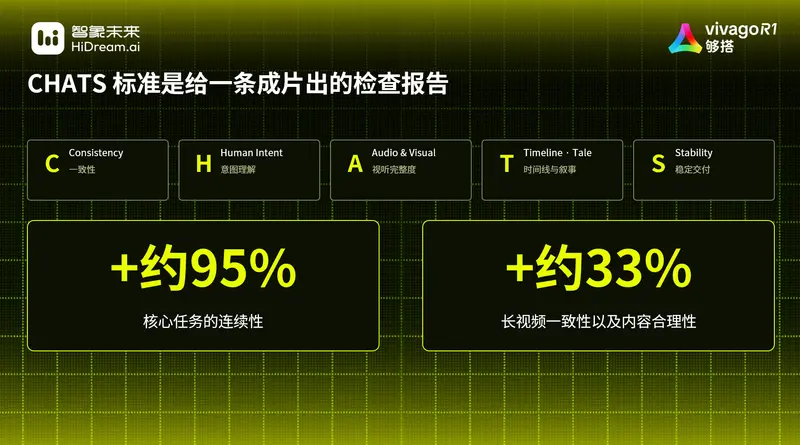
智象未来提出了一套面向视频 Agent 的评估框架 CHATS™,用于衡量 AI 是否具备真正的作品交付能力:
| 维度 | 含义 | 关键指标 |
|---|
| C (Consistency) | 一致性 | 角色、场景、风格在多镜头中保持稳定 |
| H (Human Intent) | 意图理解 | 准确理解创意,并在多轮对话中持续推进 |
| A (Audio & Visual) | 视听完整度 | 不仅生成画面,还能组织声音、节奏与整体体验 |
| T (Timeline & Tale) | 时间线与叙事 | 故事在多个镜头、段落中持续成立,逻辑自洽 |
| S (Stability) | 稳定交付 | 降低返工成本,提高内容可用率至 85%+ |
市场表现与愿景
- 用户规模:vivago.ai 自 2024 年 5 月上线以来,全球用户已突破 7000 万。
- 行业地位:曾登顶 Product Hunt 日榜第一,从“第一个可用”进化为“第一个单反级交付”。
- 品牌寓意:R1 中的 R 代表 Reasoning(用深度推理把灵感变成作品)和 Rock(致敬 “The Show Must Go On” 的创作精神)。
 够搭