
腾讯云 AI 代码助手
腾讯云 AI 代码助手是一个编辑器插件,该插件旨在通过 AI 在代码方面的行业模型能力,和编辑器的紧密联动,来提升开发者日常的开发效率。同时插件还支持对话交流、代码翻译、代码修复等一系列场景。
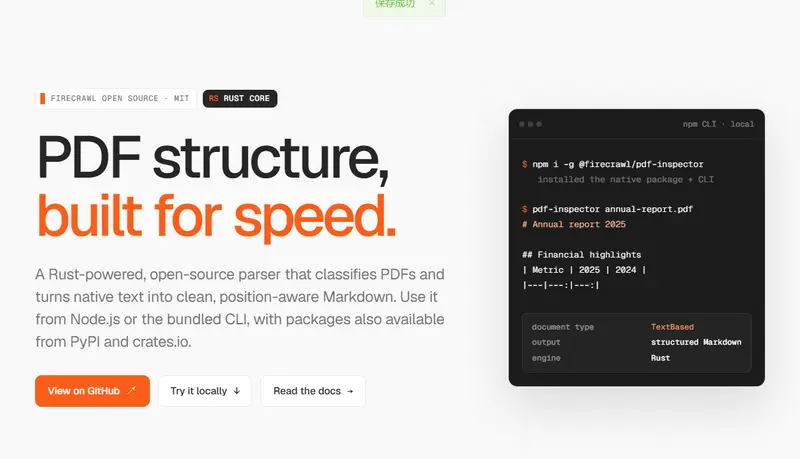
pdf-inspector 由 Firecrawl 团队开源,这是一个基于 Rust 构建的高性能本地 PDF 处理库,旨在通过智能分类和精准的结构化提取,为约 54% 无需 OCR 的 PDF 提供毫秒级的处理体验。
 pdf-inspector
在处理海量文档时,PDF 解析往往是性能瓶颈。传统的方案要么依赖昂贵的 OCR 服务,要么使用缓慢且结构丢失严重的通用解析器。pdf-inspector 由 Firecrawl 团队开源,这是一个基于 Rust 构建的高性能本地 PDF 处理库,旨在通过智能分类和精准的结构化提取,为约 54% 无需 OCR 的 PDF 提供毫秒级的处理体验。
pdf-inspector 能在极短时间内通过采样内容流,将 PDF 划分为四种类型:
系统会返回置信度分数及按页的 OCR 路由建议。这意味着你可以直接跳过那些不需要 OCR 的文档,大幅降低 API 成本和处理延迟。
不仅仅是提取文字,pdf-inspector 致力于还原文档的逻辑结构:
在 Apple M4 Pro 上对 200 个 PDF 进行的基准测试显示,pdf-inspector 在速度和综合得分上均表现优异:
| 引擎 | 总分 | 阅读顺序 (NID) | 表格 (TEDS) | 速度 (200 文档) |
|---|---|---|---|---|
| pdf-inspector | 0.875 | 0.915 | 0.814 | 0.470 秒 |
| liteparse | 0.873 | 0.913 | 0.693 | 0.750 秒 |
| opendataloader | 0.831 | 0.902 | 0.489 | 2.569 秒 |
| pymupdf4llm | 0.735 | 0.886 | 0.401 | 17.117 秒 |
| markitdown | 0.589 | 0.844 | 0.273 | 16.165 秒 |
注:测试环境为本地引擎,OCR 已禁用。pdf-inspector 在保持高准确率的同时,速度是 PyMuPDF4LLM 的 30 倍以上。
lopdf 库,极致轻量。