在 AI 智能体(Agent)处理长周期、多轮次任务时,上下文窗口爆炸与检索噪音干扰一直是阻碍其走向实用的核心痛点。新加坡国立大学(NUS)研究人员最新提出的 MRAgent 框架,通过引入受认知神经科学启发的“主动记忆重建”机制,彻底改变了传统的“检索-然后-推理”范式。数据显示,MRAgent 在处理复杂查询时,每次仅需消耗 11.8 万 Token,远低于同类框架 LangMem 的 326 万 Token,实现了成本与效率的双重飞跃。
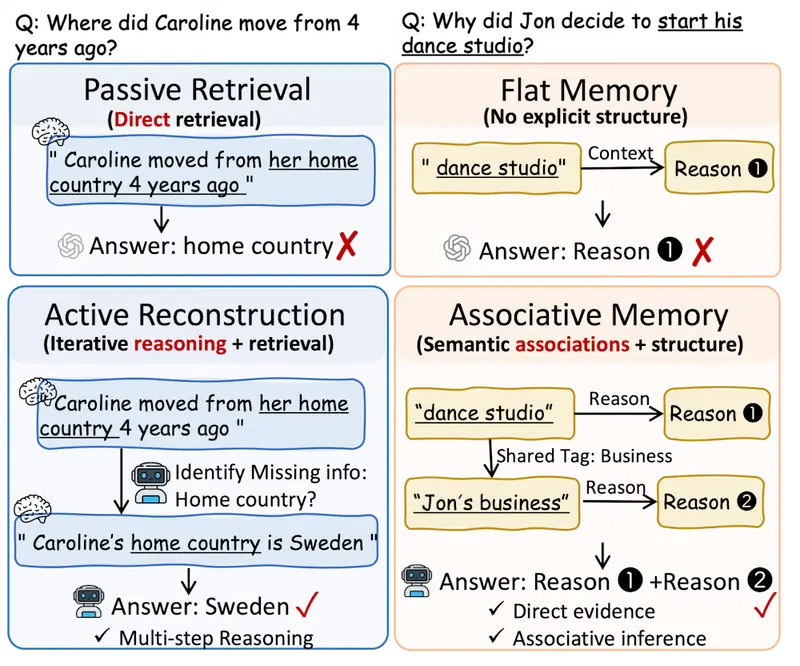
核心痛点:被动检索的三大瓶颈
传统的智能体记忆管理通常依赖向量搜索或图遍历,将文档被动地塞入 LLM 上下文。这种模式在长周期任务中暴露出明显缺陷:
- 策略僵化:无法根据推理过程中发现的新线索动态调整检索策略。
- 噪音淹没:固定的相似度匹配往往返回表面相关但实质无关的内容,挤占宝贵的上下文窗口。
- 扩展受限:依赖预构建结构,难以应对不可预测的用户交互和深层信息挖掘需求。
MRAgent 的创新:主动联想与 Cue-Tag-Content 架构
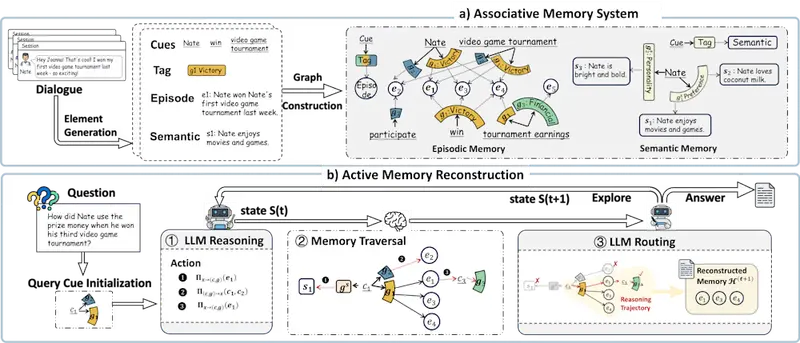
MRAgent 将记忆视为一个交互式环境,而非静态数据库。它模拟人类回忆的过程,从微小的触发点开始,逐步拼凑完整故事。其核心在于独特的 Cue-Tag-Content(线索-标签-内容) 三层关联图结构:
- Cues(线索):细粒度的关键词,作为记忆的入口。
- Tags(标签):语义桥梁,总结 Cues 与 Content 之间的关联,充当“摘要”角色。
- Content(内容):实际存储的记忆单元,按多粒度分层。
高效的两阶段检索流程
- 导航与筛选:LLM 首先从 Cues 映射到候选 Tags。由于 Tags 是简短的语义摘要,LLM 可以快速评估其相关性,丢弃不相关的分支,避免直接加载沉重的 Content。
- 精准提取:仅针对高潜力的 Cue-Tag 对,系统才会检索具体的 Content。这种“按需加载”机制极大地减少了无效 Token 的消耗。
示例场景:
当用户询问“Nate 第三次赢得电子竞技锦标赛时是如何使用奖金的?”时,MRAgent 不会盲目搜索所有关于“Nate”或“奖金”的记录,而是先提取“Nate”、“第三次”、“电竞”等 Cues,匹配到特定的 Tags,再精准定位到那次获奖的具体记录。
性能对比:极致的成本优势
在 LoCoMo 和 LongMemEval 等行业基准测试中,MRAgent 展现了压倒性的效率优势:
| 框架 | 单次查询 Token 消耗 | 相对表现 |
|---|---|---|
| MRAgent | 11.8 万 | 基准(最低) |
| A-Mem | 63.2 万 | 约为 MRAgent 的 5.4 倍 |
| LangMem | 326 万 | 约为 MRAgent 的 27.6 倍 |
此外,MRAgent 的运行时间比 A-Mem 减半,且在所有问题类型上均显著优于基线模型。其高效源于自主停止机制:系统能本能地判断何时已收集足够证据,从而避免冗余探索。
实施指南:自动化蒸馏管道
对于开发者而言,部署 MRAgent 的关键在于构建前端的自动化摄取管道:
- 后台作业:设置流式管道,实时捕获原始用户交互。
- 元数据提取:利用 LLM 提示模板,从交互历史中自动提取 Cues 和 Tags。
- 图谱填充:将结构化数据存入图数据库,完成记忆图的构建。
作者强调,这一构建阶段非常轻量,且代码已在 GitHub 开源。
相关导航
没有相关内容!




