Skill Recorder
微软最新开源的Skill Recorder 提供了一种更直观的路径:录制你的操作,AI 自动生成可复用的技能。它能捕捉你在屏幕上的真实工作会话(点击、窗口切换、页面访问及口述旁白),并利用 GitHub Copilot CLI 将这些操作重构为清晰的意图和有序步骤。
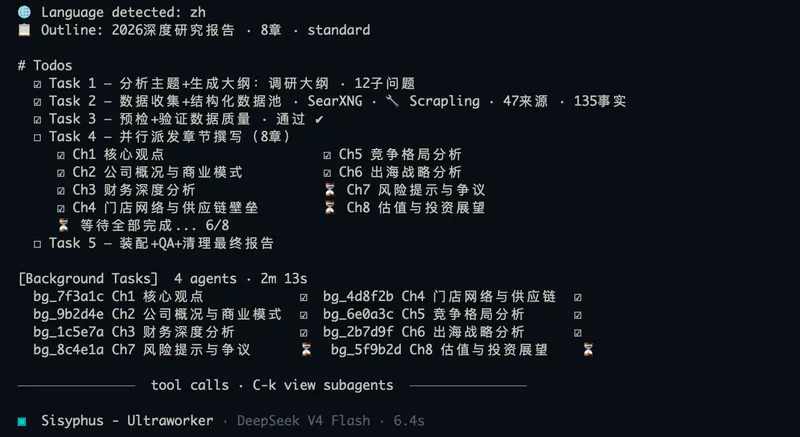
deep-research Skill 是一款开源的自动化深度调研工具,它通过严谨的四阶段工作流和四层搜索链路,将 AI 从简单的“搜索+总结”升级为具备纵深分析能力的“研究助理”。支持 19 种语言原生撰写,兼容主流 AI 编程助手,让专业级调研触手可及。
 deep-research Skill
在信息过载的时代,获取一份深度、准确且可信赖的行业调研报告往往意味着高昂的费用或漫长的等待。deep-research Skill 是一款开源的自动化深度调研工具,它通过严谨的四阶段工作流和四层搜索链路,将 AI 从简单的“搜索+总结”升级为具备纵深分析能力的“研究助理”。支持 19 种语言原生撰写,兼容主流 AI 编程助手,让专业级调研触手可及。
sources.json(30+ 优质信源,如 arXiv, World Bank, 艾瑞, 36氪等,启动时自动健康检测)。(N) 可点击引用,文末附详细参考列表。找不到来源的数字坚决不写。deep-research 并非简单调用搜索 API,而是执行一套严密的科研范式:
| 模式 | 命令 | 适用场景 | 参考字数 | 耗时 |
|---|---|---|---|---|
| Quick | /research 主题 -quick | 快速洞察、初步筛选 | ~15,000 字符 | 8–12 分钟 |
| Standard | /research 主题 | 标准行业分析、竞品调研 | ~25,000 字符 | 10–15 分钟 |
| Deep | /research 主题 -deep | 极致深度、学术级综述 | ~45,000 字符 | 15–25 分钟 |
(注:Standard 模式通常包含 8-12 章,15-25 张数据表,引用 15-25 家独立机构)