精挑翻译
精挑翻译(SelectTranslate)是一款免费开放的 AI 翻译插件,支持双语网页、PDF、视频字幕、图片漫画、在线会议及ePub电子书翻译,行业首创择优翻译可调用多款AI模型智能评分并推荐更优译文。集成DeepSeek、ChatGPT、Gemini、Qwen等20+主流模型,支持100+语言
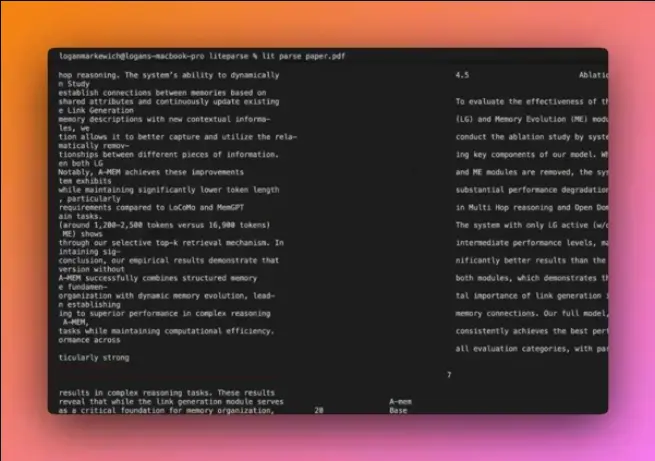
LiteParse 是一个独立的开源 PDF 解析工具,专注于快速、轻量级的解析。它提供带边界框的高质量空间文本解析,没有专有 LLM 功能或云依赖。一切都在本地运行。
 LiteParse
在构建基于大语言模型(LLM)的应用时,高质量的数据解析是至关重要的一环。LiteParse 是一个独立的开源 PDF 解析工具,专为追求速度、轻量级和本地化的开发者设计。它摒弃了专有 LLM功能和云依赖,所有处理均在本地完成,提供带精确边界框的空间文本解析,是构建私有化、低成本 AI 应用的理想选择。
TESSDATA_PREFIX 环境变量轻松管理离线语言包,适用于隔离环境。lit 命令行界面,方便脚本化批量处理。| 功能模块 | 详细描述 |
|---|---|
| 文本解析 | 提取带坐标的文本,支持加密文档解锁,可指定页面范围 |
| OCR 增强 | 内置 Tesseract,支持多语言,可切换外部 HTTP OCR 服务 |
| 截图生成 | 将 PDF 页面渲染为高清图片,支持自定义 DPI 和页码 |
| 格式转换 | 自动将 Word (.docx), PPT (.pptx), Excel (.xlsx), 图像 (.jpg/.png) 等转换为 PDF 后解析 |
| 批量处理 | 支持递归目录扫描,并发处理大量文档 |
| Agent 集成 | 可作为 Skill 直接嵌入 LlamaIndex 等 Agent 框架 |
根据开发语言选择安装方式:
# Python
pip install liteparse

# Node.js / TypeScript
npm i @llamaindex/liteparse

# Rust (CLI)
cargo install liteparse

# Browser (WASM)
npm i @llamaindex/liteparse-wasm
解析单个文件:
# 基本解析(默认启用 OCR)
lit parse document.pdf

# 指定输出格式为 JSON
lit parse document.pdf --format json -o output.json

# 禁用 OCR(仅提取原生文本)
lit parse document.pdf --no-ocr

# 指定法语 OCR
lit parse document.pdf --ocr-language fra
生成截图(用于多模态分析):
# 截图所有页面,输出到 screenshots 目录
lit screenshot document.pdf -o ./screenshots

# 截图第 1, 3, 5 页,300 DPI
lit screenshot document.pdf --target-pages "1,3,5" --dpi 300 -o ./screenshots
批量处理目录:
lit batch-parse ./input-directory ./output-directory --recursive
将 LiteParse 作为技能添加到你的 Agent 中:
npx skills add run-llama/llamaparse-agent-skills --skill liteparse
建议:对于常规文档优先使用 LiteParse;遇到解析极限时,再考虑切换到 LlamaParse。