Cloudflare Quick Tunnels
Cloudflare 近日上线 Quick Tunnels 功能,允许开发者在无需注册账号、无需购买服务器、无需配置域名的前提下,将本地运行的服务即时暴露为可公开访问的 HTTPS 地址。
 Polar
随着 AI Agent 能力的增强,对其进行的强化学习(RL)训练变得日益复杂。传统的 RL 基础设施往往要求将 Agent 软件(Harness)重写为特定的环境 API,这不仅工程量大,还容易丢失原生执行细节。英伟达研究团队推出的 Polar 框架,通过创新的“API 网关代理”机制,实现了在无需修改任何 Harness 代码的前提下,对 Codex、Claude Code、Qwen Code 等主流 Agent 进行高效的 GRPO 训练。
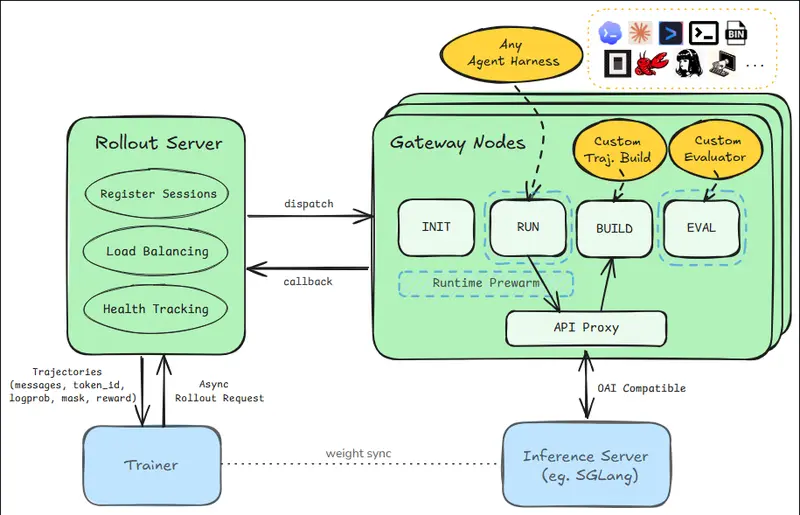
Polar 的核心洞察在于:所有基于 LLM 的 Agent 都必须调用模型 API。Polar 在此边界处放置了一个网关代理(Gateway Proxy),而非侵入 Harness 内部。
对于每个模型请求,网关自动执行:
注:对于流式请求,Polar 合成符合规范的 SSE 流,确保完整捕获。
用户只需将 Harness 的模型 base URL 指向 Polar 网关,即可开始训练,无需重写任何业务逻辑。
Polar 由 Rollout 服务器 和 网关节点 组成,支持 Docker 和 Apptainer 运行时。
per_request:将每次调用视为独立轨迹。无损但割裂上下文,增加训练负担。prefix_merging(推荐):通过验证 Token 前缀关系,将多轮对话合并为长轨迹。仅标记被采样的 Assistant Token 为可训练,其余掩码为零。per_request,训练器更新次数减少 81%,挂墙时间缩短 5.39 倍,GPU 利用率从 20.4% 提升至 87.7%。研究团队在 Qwen3.5-4B 基模型上,使用标准 GRPO 进行了实验:
| Harness | 基模型分数 | Polar RL 分数 | 提升幅度 |
|---|---|---|---|
| Codex | 3.8% | 26.4% | +22.6 点 🚀 |
| Pi | 34.2% | 40.4% | +6.2 点 |
| Claude Code | 29.8% | 34.6% | +4.8 点 |
| Qwen Code | 34.6% | 35.2% | +0.6 点 |
Polar 是目前唯一在以下四个维度均提供一流支持的系统:
相比之下,ProRL Agent、SkyRL-Agent 等竞品在 Harness 兼容性或异步能力上存在局限。
无论是希望提升现有 Agent 性能的开发者,还是致力于构建大规模 Agent 训练平台的研究机构,Polar 都提供了一个强大且灵活的开源解决方案(Apache-2.0 许可,基于 NeMo Gym)。立即体验 Polar,解锁 Agent 智能进化的新潜力!