SkillOpt

5个月前发布 211 00

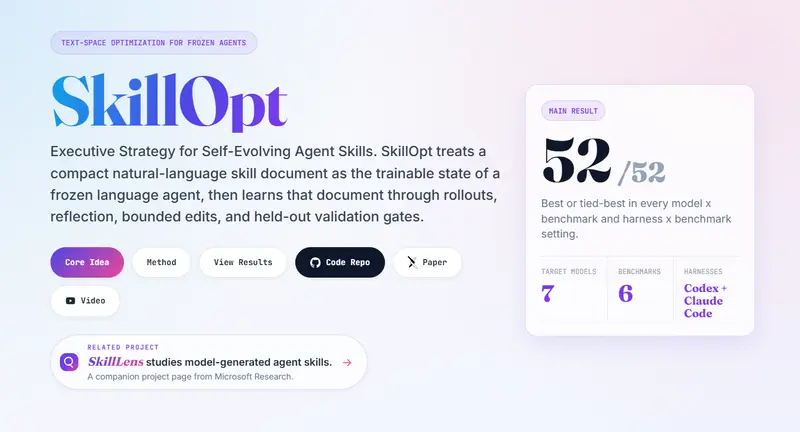
微软研究院提出的 SkillOpt,首次将深度学习的优化理念引入文本空间,打造了一个系统性、可控的 AI 技能自我进化框架。SkillOpt 不再依赖玄学的 Prompt 工程,而是通过严格的验证机制和受控的编辑策略,让 AI 的技能文档在反复实践中自动迭代、越变越强。

所在地:
美国
收录时间:
2026-05-28
其他站点:
SkillOptSkillOpt

在 AI Agent 应用中,高质量的“技能文档”(即系统提示词或操作指南)是决定模型表现的关键。然而,传统的手工编写或单次生成方式往往效率低下且难以维持最佳状态。微软研究院提出的 SkillOpt,首次将深度学习的优化理念引入文本空间,打造了一个系统性、可控的 AI 技能自我进化框架。
SkillOpt

SkillOpt 不再依赖玄学的 Prompt 工程,而是通过严格的验证机制和受控的编辑策略,让 AI 的技能文档在反复实践中自动迭代、越变越强。

核心亮点:像训练神经网络一样训练“文本技能”

1. 系统性文本空间优化

  • 独立优化器模型:由一个独立的 LLM 充当“教练”,分析执行日志,提出精准的增/删/改建议。
  • 受控编辑:引入**“文本学习率预算”**,限制每次修改的幅度,防止“改崩”;早期宽松探索,后期精细调整。
  • 严格验证关卡:所有修改必须在预留的验证集上严格提高分数才会被接受,确保技能是真正“学会”而非“过拟合”。

2. 失败经验缓冲与慢更新

  • 拒绝缓冲区:记录被拒绝的修改尝试,避免重复踩坑。
  • 周期性慢更新:每个训练周期结束后,对比长期表现,将持久的改进写入技能文档的“受保护区域”,防止短期波动覆盖核心知识。

3. 便携式与跨平台通用

  • 零推理开销:优化后的技能文档仅为几百至两千词的文本文件,部署时无需额外模型调用。
  • 一次训练,到处运行:技能文档不绑定特定模型或框架,可在 GPT-5.5、Codex、Claude Code 等不同环境间无缝迁移。

工作原理:AI 技能训练营七步法

  1. 布置作业:AI 带着当前技能文档批量执行训练任务,记录完整日志。
  2. 分组复盘:“教练”模型分析日志,识别反复出现的系统性错误模式。
  3. 开处方:针对错误模式,提出结构化的增删改建议(如“增加权威来源优先规则”)。
  4. 控制药量:根据学习率预算,限制单次修改数量,确保小步快跑。
  5. 模拟考试:在验证集上测试修改后的技能,只有分数严格提升才采纳。
  6. 阶段总结:周期结束时进行长期评估,固化持久改进,更新战略指导。
  7. 毕业出口:输出最佳技能文档 best_skill.md,即插即用。

性能表现:全面领先,小模型逆袭

SkillOpt 在 6 个基准测试、7 种模型、3 种执行环境的 52 个评估单元中全部取得第一或持平。

模型/场景提升幅度典型案例
GPT-5.5 (Direct Chat)+23.5%平均准确率显著提升
GPT-5.5 (Codex)+24.8%代码执行任务大幅优化
GPT-5.5 (Claude Code)+19.1%智能体框架下表现稳健
Qwen3.5-4B (Small Model)+50.7%虚拟决策从 30.6% → 81.3%
Spreadsheet Task+38.9%从 41.8% → 80.7%

注:在 Codex 中训练的技能,直接迁移至 Claude Code,表格处理成绩从 22.1% 暴涨至 81.8%,证明其学到了可迁移的通用方法。
应用场景

  • 🏢 企业自动化办公:自动生成 Excel 处理、公文写作等“最佳实践手册”,新员工(新 AI)入职即上手。
  • 📱 个人效率助手:AI 在互动中自动总结用户偏好,生成个性化技能文档,越用越顺手。
  • 🎓 教育辅导:自动提炼学生易错点,生成透明可审计的辅导策略。
  • 🔒 AI 安全合规:所有技能均为人类可读文本,便于审查偏见与错误,比黑箱参数更安全可靠。

相关导航