RD罕见病诊断系统(DeepRare)
DeepRare 是首个基于大型语言模型(LLM)的罕见病诊断系统,专门用于罕见病的诊断,能够处理多种临床输入,包括自由文本临床描述、结构化的表型本体(HPO)术语和基因检测结果(VCF 格式),并生成带有透明推理链的罕见病诊断假设列表。
 Needle
在大型语言模型日益庞大的今天,如何让 AI 真正运行在手机、手表、眼镜等资源受限的消费级设备上,一直是行业难题。Needle 是由 Cactus 团队基于 Gemini 3.1 蒸馏而成的实验性模型,参数量仅为 2600 万 (26M)。
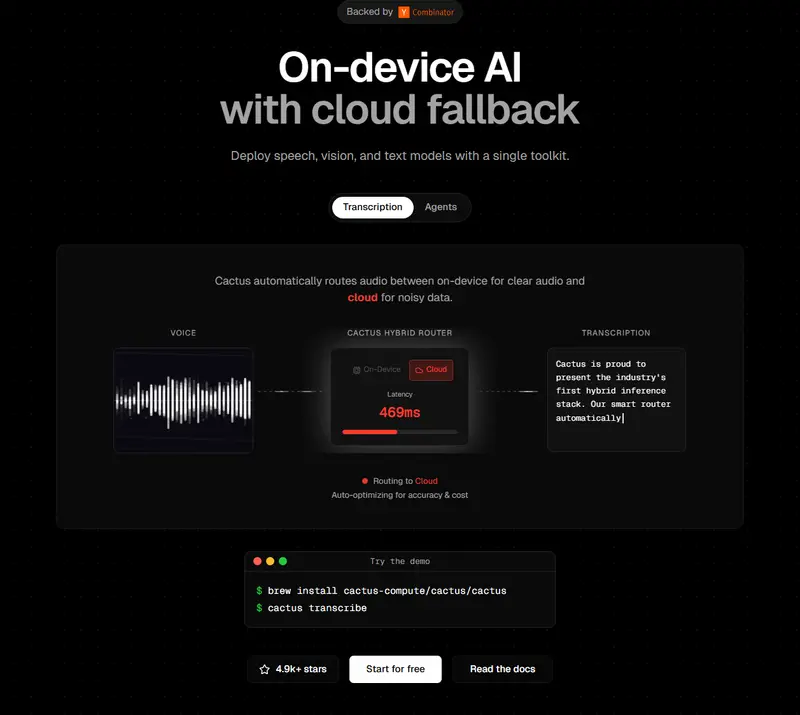
尽管体量极小,Needle 在单次函数调用任务上展现了惊人的性能,不仅击败了 FunctionGemma-270m、Qwen-0.6B 等更大规模的模型,更在 Cactus 推理引擎上实现了 6000 token/秒 的预填充速度和 1200 token/秒 的解码速度。这意味着,你可以在自己的 Mac 或 PC 上流畅运行,甚至进行本地微调,让真正的“离线个人 AI 助理”成为可能。
Cactus-Compute/needle 仓库公开,透明可审计。| 场景 | 痛点 | Needle 解决方案 |
|---|---|---|
| 智能手表/手环 | ❌ 云端延迟高,离线功能弱 | ✅ 本地实时解析语音指令,控制设备功能,零延迟响应 |
| AR/VR 眼镜 | ❌ 算力受限,电池续航短 | ✅ 超低功耗运行,快速调用导航、翻译、识别等工具 |
| 智能家居中枢 | ❌ 隐私担忧,依赖网络连接 | ✅ 完全本地化处理,保护用户隐私,断网可用 |
| 个人 AI 助理 App | ❌ API 调用成本高,响应慢 | ✅ 端侧免费运行,极速提取意图并调用手机原生 API |
| IoT 嵌入式设备 | ❌ 芯片性能弱,无法部署大模型 | ✅ 26M 参数轻松嵌入低端 MCU/NPU,赋予设备智能交互能力 |