ClawWork
ClawWork 是一个开源的 OpenClaw 桌面客户端,一个专为 OpenClaw 打造的专业级工作空间(Workspace),支持桌面端(Windows/macOS/Linux)和移动端(PWA),旨在将你的多会话生产力提升 10 倍。
腾讯云正式开源 TencentDB Agent Memory,一款面向 Agent 长任务场景的记忆管理解决方案。让 Agent 学会你的工作流程、保留任务上下文、复用历史经验——以符号化记忆化解单次长任务的信息过载,以分层记忆沉淀跨会话的经验资产。
 TencentDB Agent Memory
随着 AI Agent 在代码开发、复杂搜索及研究分析等场景中的应用日益深入,长上下文窗口带来的 Token 成本激增、状态丢失及推理稳定性下降成为行业痛点。腾讯云正式开源 TencentDB Agent Memory,一款面向 Agent 长任务场景的记忆管理解决方案。
该方案首创性地结合“上下文卸载(Context Offloading)”与“Mermaid 任务画布”技术,通过符号化短期记忆与分层式长期记忆的双轮驱动,在大幅降低 Token 消耗的同时,显著提升任务成功率与记忆准确性。目前,该方案已作为插件完美适配 OpenClaw 和 Hermes 等主流 Agent 框架。
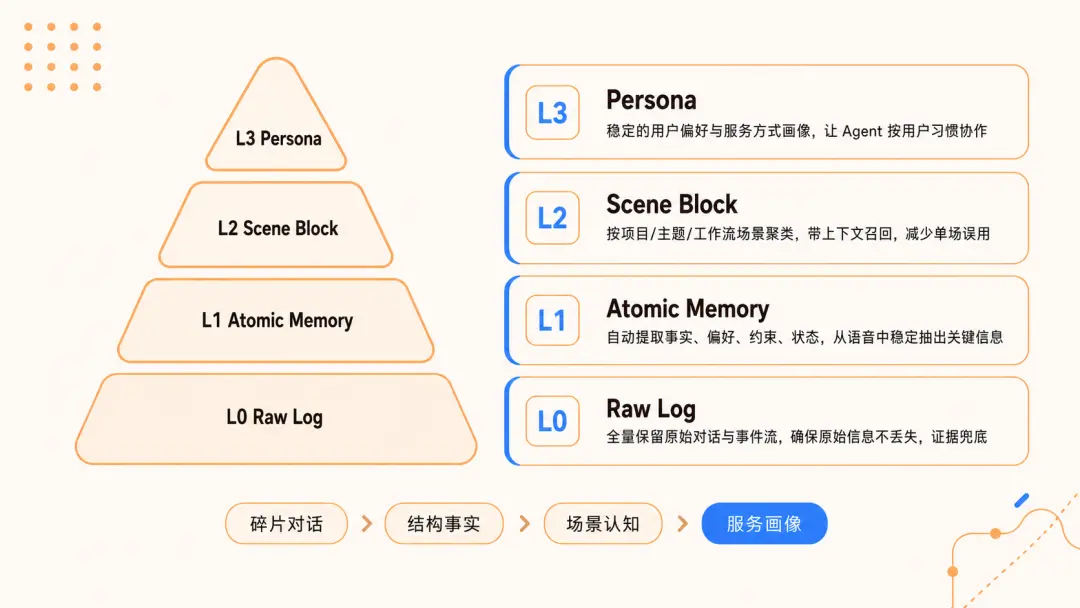
node_id 瞬间回溯到底层原文(refs/*.md),实现100% 可追溯。打破传统记忆系统将所有数据平铺为向量的局限,构建四层语义金字塔:
~/.openclaw/memory-tdai/)。Persona → Scenario → Atom → Conversation 的链路逐层定位问题。| 记忆能力 | Benchmark | OpenClaw 成功率 | +插件后成功率 | 相对变化 | OpenClaw Token 消耗 | +插件后 Token 消耗 | 相对变化 |
|---|---|---|---|---|---|---|---|
| 短期记忆 | WideSearch | 33% | 50% | +51.52% | 221.31M | 85.64M | -61.38% |
| 短期记忆 | SWE-bench | 58.4% | 64.2% | +9.93% | 3474.1M | 2375.4M | -33.09% |
| 短期记忆 | AA-LCR | 44.0% | 47.5% | +7.95% | 112.0M | 77.3M | -30.98% |
| 长期记忆 | PersonaMem | 48% | 76% | +59% | — | — | — |
注:SWE-bench 测试模拟真实长程压力,每个 Session 连续执行 50 个任务。
openclaw plugins install @tencentdb-agent-memory/memory-tencentdb
openclaw gateway restart
在 ~/.openclaw/openclaw.json 中添加:
{
  "memory-tencentdb": {
    "enabled": true
  }
}
默认使用本地 SQLite + sqlite-vec 后端,自动完成对话录制、记忆提取与召回。
步骤一:注册 Slot
{
  "plugins": {
    "slots": {
      "contextEngine": "openclaw-context-offload"
    }
  }
}
步骤二:执行 Patch 脚本
注入 after-tool-call 消息钩子,确保工具调用结果被正确卸载:
bash scripts/openclaw-after-tool-call-messages.patch.sh
注:每次安装或升级 OpenClaw 后建议重新执行。
通过一条命令即可启动带记忆能力的 Hermes Gateway:
docker run -d \
  --name hermes-memory \
  --restart unless-stopped \
  -p 8420:8420 \
  -e MODEL_API_KEY="your-api-key" \
  -e MODEL_BASE_URL="https://api.lkeap.cloud.tencent.com/v1" \
  -e MODEL_NAME="deepseek-v3.2" \
  -v hermes_data:/opt/data \
  hermes-memory
内置腾讯云 DeepSeek-V3.2 默认配置,仅需传入 API Key 即可运行。
| 层级 | 参数示例 | 说明 |
|---|---|---|
| Level 1 (日常调参) | recall.strategy: "hybrid" | 召回策略:keyword / embedding / hybrid (RRF 融合,推荐) |
offload.enabled: false | 是否启用短期记忆压缩(设为 true 开启) | |
| Level 2 (进阶调优) | pipeline.enableWarmup: true | Warm-up:新 session 从 1 轮起触发,每次翻倍至 N |
offload.aggressiveCompressRatio: 0.85 | 激进压缩触发比例(占 context window) | |
| Level 3 (运维/自定义) | embedding.* | 配置远程 Embedding 服务(OpenAI 兼容 API) |
llm.* | 独立 LLM 模式,绕过内置模型跑记忆提取 |