AutoScientist
AutoScientist是一款旨在自动化传统微调流程的 AI 工具。它不仅能处理数据,更能同步优化模型架构与训练策略,帮助模型快速掌握特定领域能力。Adaption 宣称,AutoScientist 能将不同模型的胜率提高一倍以上,标志着前沿 AI 训练正从“手工匠艺”迈向“自动化工业”。
TokenSpeed 是一个专为代理工作负载设计的光速级 LLM 推理引擎,兼具 TensorRT-LLM 级别的性能和 vLLM 级别的可用性。我们的目标是成为生产级代理工作负载中性能最高的推理引擎。
 TokenSpeed
随着 Claude Code、Codex、Cursor 等 AI 编程助手从工具演变为基础设施,大模型推理负载发生了根本性变化:超长上下文(50k+ Tokens)、多轮密集交互成为常态。传统推理引擎在应对这类“智能体负载”时,往往难以兼顾单用户响应速度(TPS)与整体吞吐量(TPM)。
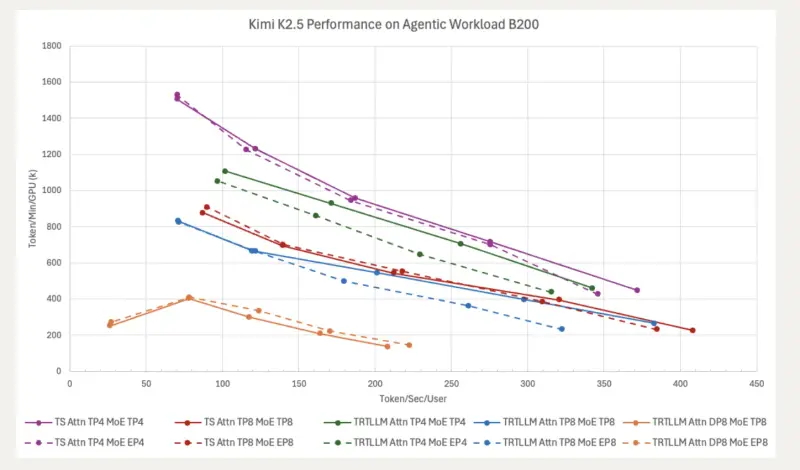
LightSeek 基金会发布了 TokenSpeed——一款基于 MIT 协议开源、专为智能体工作负载定制的大语言模型推理引擎。在英伟达 B200 平台上的基准测试显示,TokenSpeed 在多项关键指标上全面领先行业标杆 TensorRT-LLM,尤其在推测解码场景下,推理延迟几乎减半。
TokenSpeed 并非通用引擎的简单修改,而是针对智能体交互特性(长上下文、高并发、低延迟敏感)从头构建:
引入 C++ 有限状态机 (FSM) 作为控制面核心,将 KV 缓存的状态迁移、复用规则及所有权语义嵌入类型系统。
针对英伟达 Blackwell 架构,自研高性能 MLA (Multi-Head Latent Attention) 内核:
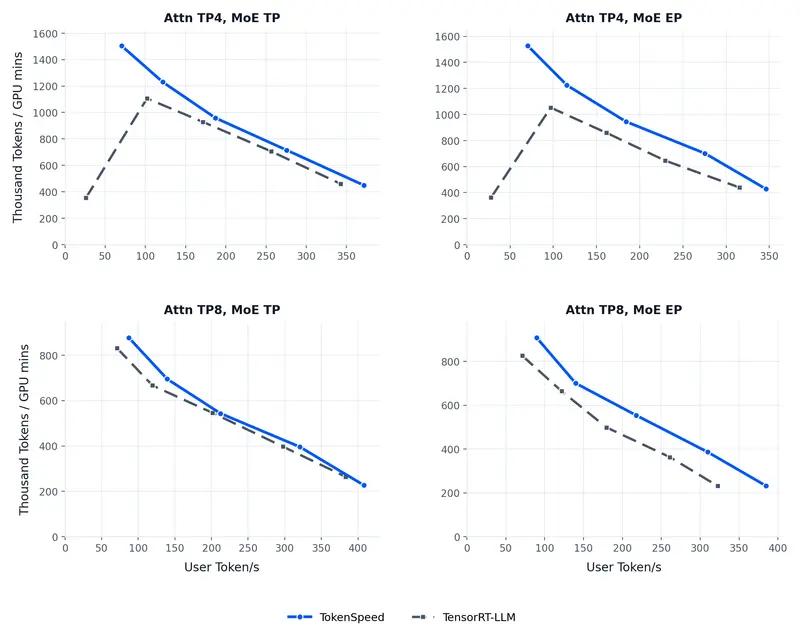
在 NVIDIA B200 平台上,使用 Kimi K2.5 模型,针对智能体典型负载(批大小 1/4/8/16,带长前缀 KV 缓存)进行对标测试:
| 场景指标 | TokenSpeed 表现 | 对比 TensorRT-LLM |
|---|---|---|
| 最小延迟 (Batch=1) | 极致低延迟 | 快约 9% 🟢 |
| 高吞吐 (100 TPS/用户) | 高并发稳定 | 高出约 11% 🟢 |
| 推测解码 (Batch=4/8/16) | 长上下文高效处理 | 延迟几乎减半 🚀 |
| 预填充负载 | 5 类典型场景全覆盖 | 全面超越 🟢 |
💡 最佳配置:在单用户 70+ TPS 场景下,「注意力张量并行 TP4 + MoE 张量并行 TP4」组合表现最优。