Prism - 最新版
Prism 是一款开源的桌面 AI 翻译应用,支持 Windows、macOS 和 Linux,内置 AI 翻译 + OCR 截图识别,所有数据本地存储,且完全兼容 OpenAI 协议——你可以自由接入任何支持该协议的模型服务。
ghost-infer 是轻量 Rust 编写的本地 GGUF 推理程序,主打单用户、单消费级 GPU场景,附带桌面客户端,提供 OpenAI 兼容 API;针对 MoE 混合专家模型做了专项优化,在显存不足、模型大于 GPU 显存时对比 llama.cpp、Ollama 有明显提速。
18.7MB0 人已下载 手机查看
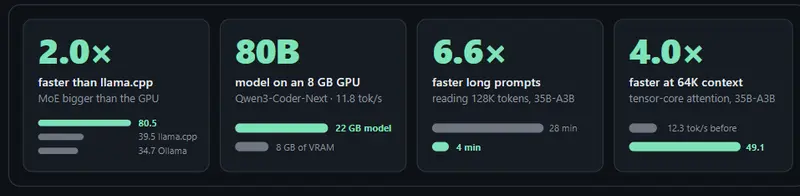
ghost-infer 是一款基于 Rust 编写的轻量级本地大语言模型(LLM)推理工具。与为数据中心设计的重型引擎不同,它专为“单人、单卡、单模型”的消费级场景深度调优。通过创新的显存管理策略和精确推测解码技术,ghost-infer 能够在显存远小于模型体积的 NVIDIA 显卡上,以超越 llama.cpp 和 Ollama 的速度流畅运行大型混合专家(MoE)模型,并提供 OpenAI 兼容 API 及功能丰富的桌面应用。
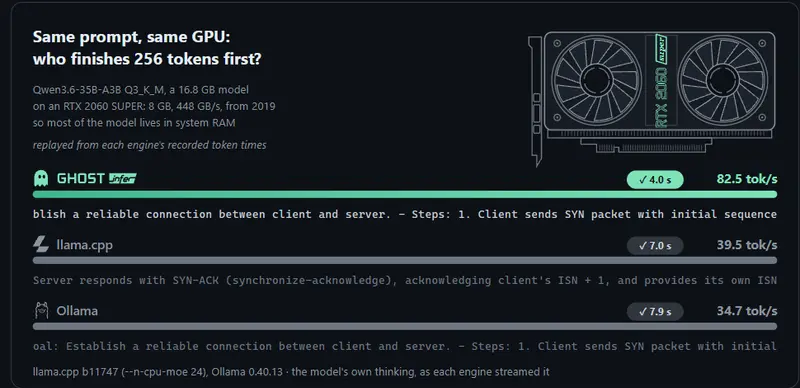
ghost-infer 的核心优势在于其对混合专家(MoE)模型的极致优化。针对 MoE 模型每层仅激活少数专家的特性,它采用了一种独特的分层执行策略:
性能对比(RTX 2060 SUPER, 8GB VRAM):
| 模型 | ghost-infer | llama.cpp | Ollama | 提升幅度 |
|---|---|---|---|---|
| Qwen3.6-35B-A3B (16.8GB) | 80.5 tok/s | 39.5 tok/s | 34.7 tok/s | ~2x |
| Qwen3-30B-A3B (13.7GB) | 68.7 tok/s | 29.5 tok/s | 26.9 tok/s | ~2.3x |
| Qwen3 8B (5GB) | 75.3 tok/s | 64.7 tok/s | 65.8 tok/s | ~1.2x |
此外,ghost-infer 支持精确推测解码,通过猜测后续 Token 并一次性验证,在不改变输出文本的前提下显著提升生成速度(在代码编辑等重复性工作中可达 3.2 倍加速)。
/v1/chat/completions 接口,支持流式传输和工具调用。--kv q4),大幅降低长聊天的显存占用。Windows 用户:
下载 GhostSetup 安装包,无需管理员权限即可运行。应用会自动引导下载推荐模型(如 Qwen3.6-35B-A3B)或使用本地已有的 GGUF 文件。
从源码构建:
git clone https://github.com/affifuddin-hazam/ghost-infer
cd ghost-infer
cargo build --release
# 启动服务
target\release\ghost-infer serve models\Qwen3-8B-Q4_K_M.gguf --gpu
系统要求: