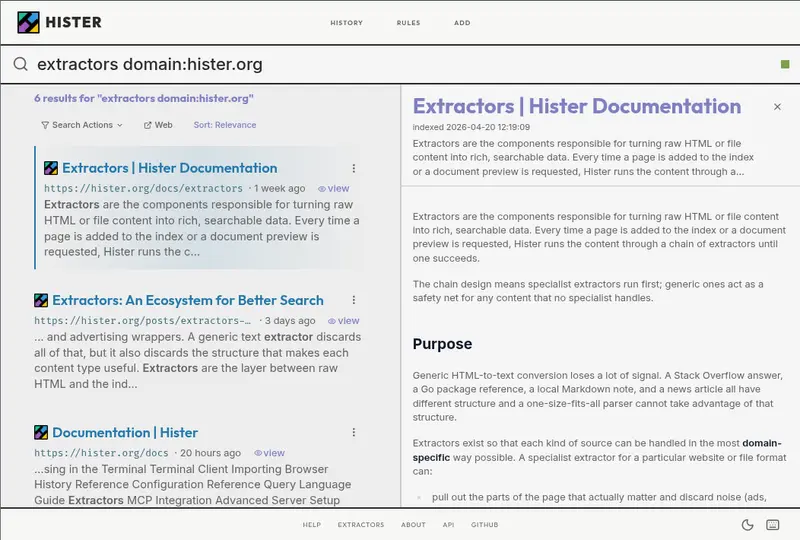
Hister 是一款注重隐私的本地搜索引擎,旨在索引你访问过的网页内容和本地保存的文件。它不仅仅是一个书签管理器,更是一个能够检索页面完整文本内容的强大工具。通过 Web 界面、终端(TUI/CLI)或 MCP(Model Context Protocol)连接的 AI 助手,你可以随时找回那些散落在浏览器历史和本地文件夹中的宝贵信息。
- 官网:https://hister.org
- GitHub:https://github.com/asciimoo/hister

核心亮点
- 极致隐私保护:
- 无遥测、无云同步:所有数据均存储在你控制的本地服务器或私有基础设施上。
- 数据主权:除了下载页面 favicon 外,浏览器扩展仅将内容发送到你指定的 Hister 实例,确保信息不出域。
- 真正的全文索引:
- 不仅搜索标题和 URL,更能深入检索网页正文和本地文件的实际内容。
- 支持强大的查询语法:字段筛选、短语匹配、通配符、否定操作、别名及结果优先级排序。
- AI 原生集成 (MCP):
- 通过 MCP 协议,Hister 可以直接作为上下文源接入 Claude Code、Cursor 等 AI 助手。
- AI 可以“阅读”你过去的浏览记录和文档,基于你的个人知识库提供更精准的回答。
- 多端访问体验:
- Web 界面:直观的搜索面板,支持安装 Firefox/Chrome 扩展自动索引新访问页面。
- 终端 (TUI/CLI):适合开发者的命令行搜索体验。
- 语义搜索(可选):可配置嵌入端点,实现基于含义而非关键词的智能检索。
快速开始
Hister 采用单二进制文件设计,部署极其简单。
- 下载与重命名:
从 GitHub Releases 下载对应平台的二进制文件,重命名为 hister (Windows 下为 hister.exe)。 - 赋予执行权限 (Linux/macOS):
chmod +x hister
- 启动服务:
- Linux/macOS:
./hister listen - Windows (PowerShell):
.\hister.exe listen
- 配置客户端:
打开浏览器访问 http://127.0.0.1:4433,根据提示安装浏览器扩展以开始自动索引。
适用场景
- 研究人员与学生:快速回溯之前阅读过的论文、文章细节,无需重新打开几十个标签页。
- 开发者:通过 MCP 让 AI 助手了解你最近查阅的技术文档和项目资料,提升编码辅助的上下文相关性。
- 知识工作者:建立个人的“第二大脑”,将碎片化的网页信息和本地笔记统一索引,实现跨来源的知识检索。
隐私说明
- 默认设置:完全离线运行,无任何外部数据发送。
- 语义搜索注意:若启用基于向量的语义搜索,文档文本会被发送到你配置的嵌入模型端点(可以是本地 Ollama 或远程 API)。建议在使用远程端点前仔细审查隐私策略。