
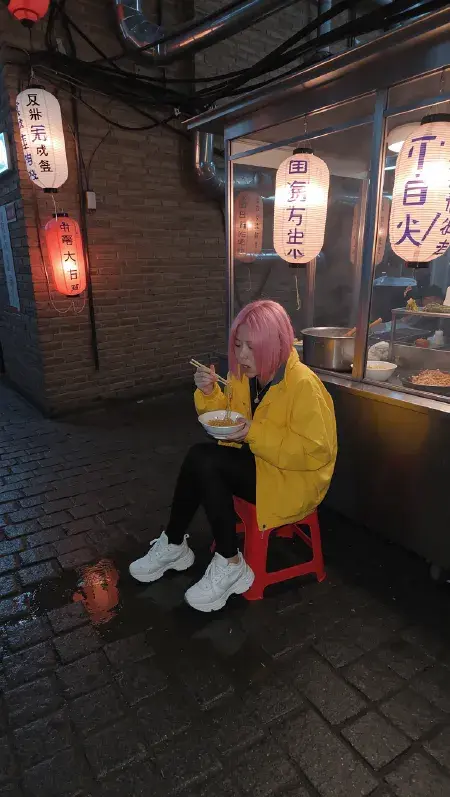
Smartphone Snapshot Photo Reality
Smartphone Snapshot Photo Reality 是一款专为 FLUX.2-klein-base-9B 模型设计的 LoRA,它旨在打破这种完美主义,生成看起来像是用 三星 Galaxy A52 智能手机随意拍摄的、充满真实感的日常快照。
Obscura Remova
Obscura Remova 是一个专为 LTX 2.3 模型设计的 Video-to-Video (V2V) LoRA, 它不仅能简单地“擦除”物体,更能基于视频中保留的稀疏视觉数据,智能重建被遮挡的背景细节,实现自然且连贯的视频修复效果。
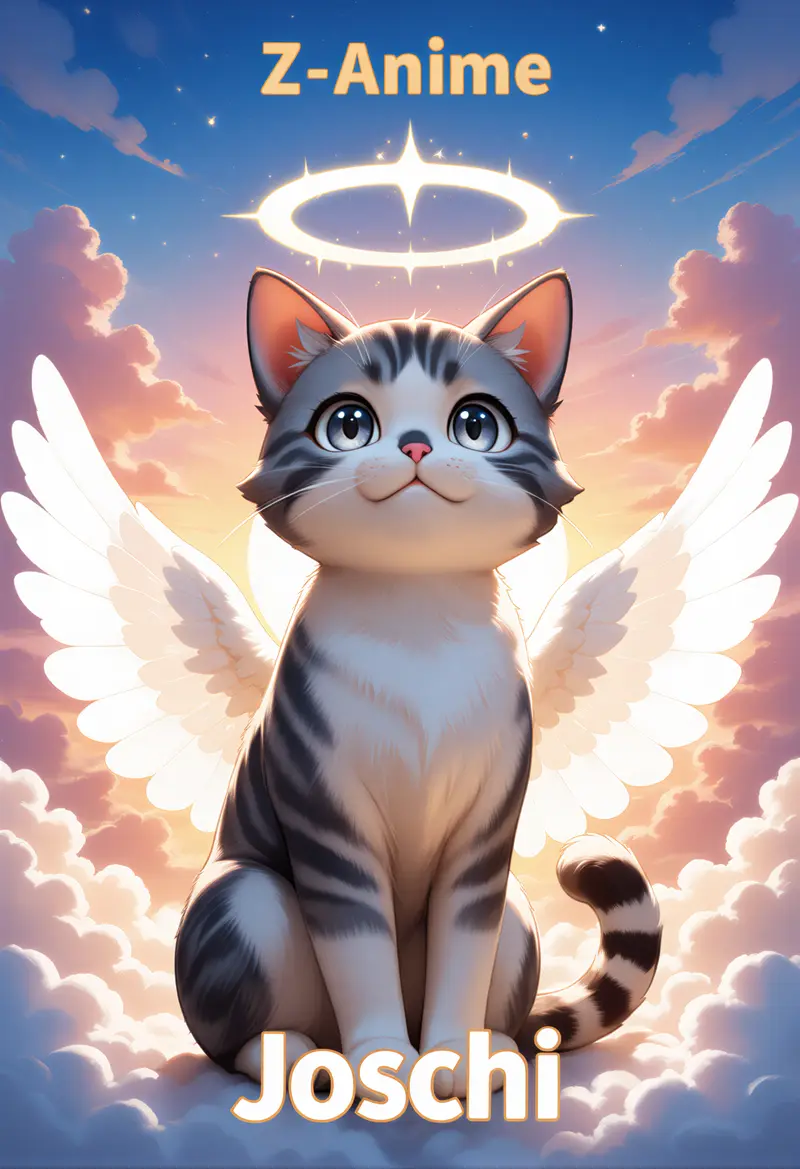
Z-Anime
Z-Anime 是阿里巴巴 Z-Image Base 架构的完整微调版本——并非 LoRA 合并,而是从零开始构建的、专注于动漫风格的完整模型系列。
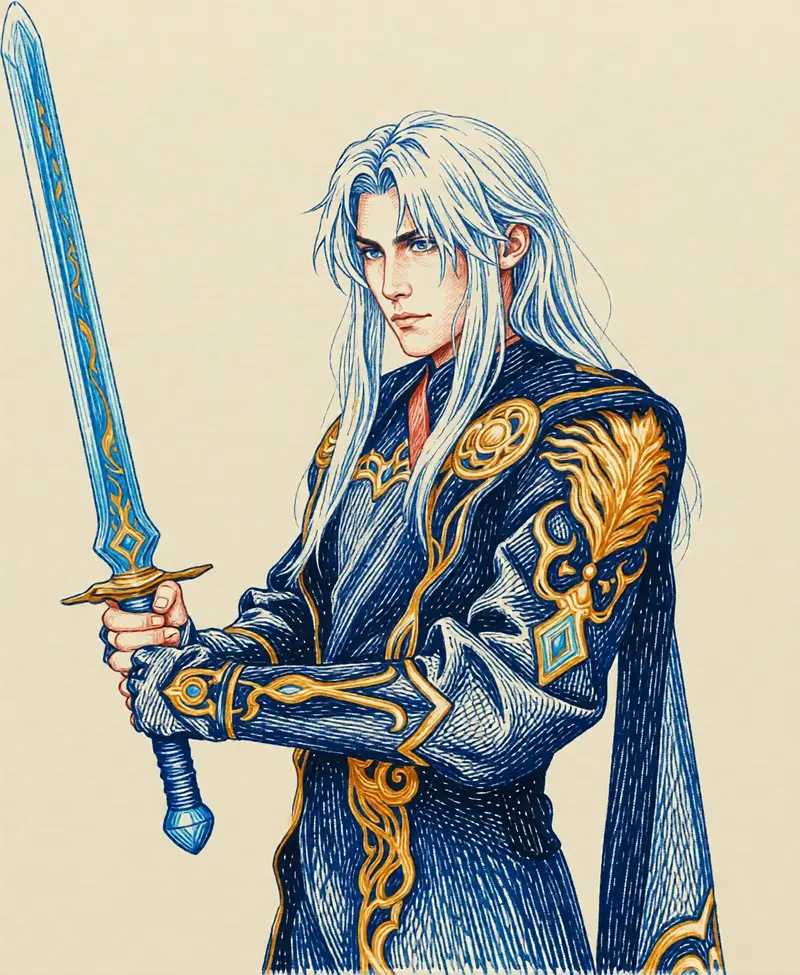
Style-Transfer
Style-Transfer 是一款基于 Qwen-Image-Edit-2511 架构的实验性 LoRA 微调模型,专为风格转换与艺术变换设计。它能够将参考图像(如卡通、线稿、插画)的视觉风格精准迁移到源图像(如真人照片)上,同时最大程度保留源图像的结构与构图。
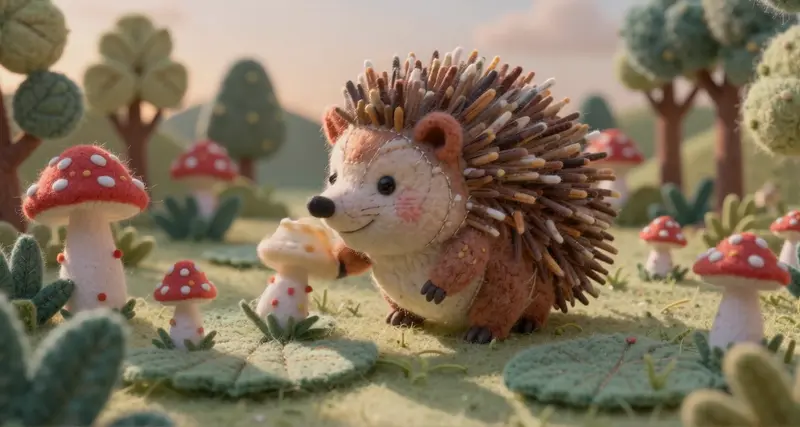
LTX2.3_Cozy_Felt_Style_LoRA(毛毡剪纸立体布景 LoRA)
LTX2.3_Cozy_Felt_Style_LoRA 是一款专为LTX-Video设计的风格化 LoRA。它能将任何输入转化为温馨、手工制作的毛毡剪纸电影感立体布景(Diorama)。
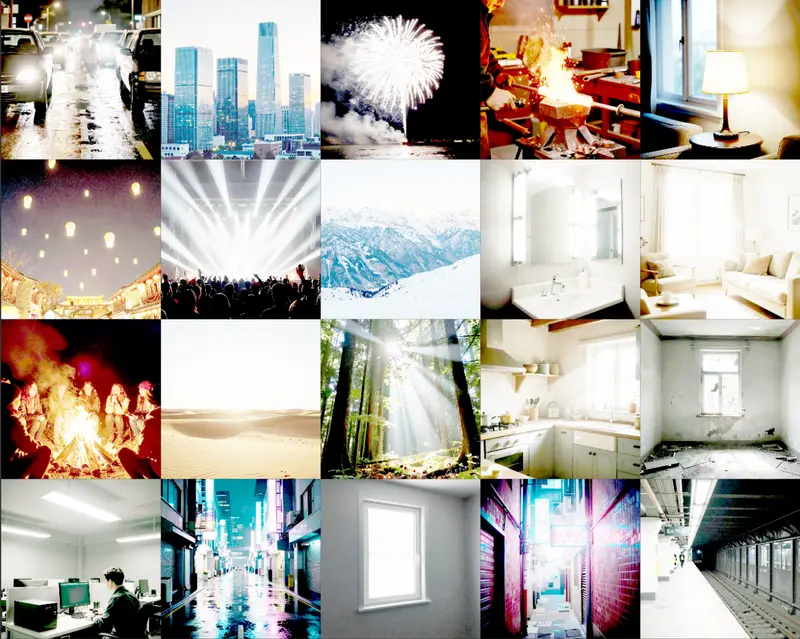
LumiPic
LumiPic 是一款基于扩散变换器(DiT)的 LoRA 模型,将标准的 SDR(标准动态范围) 图像转换为高保真的 HDR(高动态范围)EXR 文件。
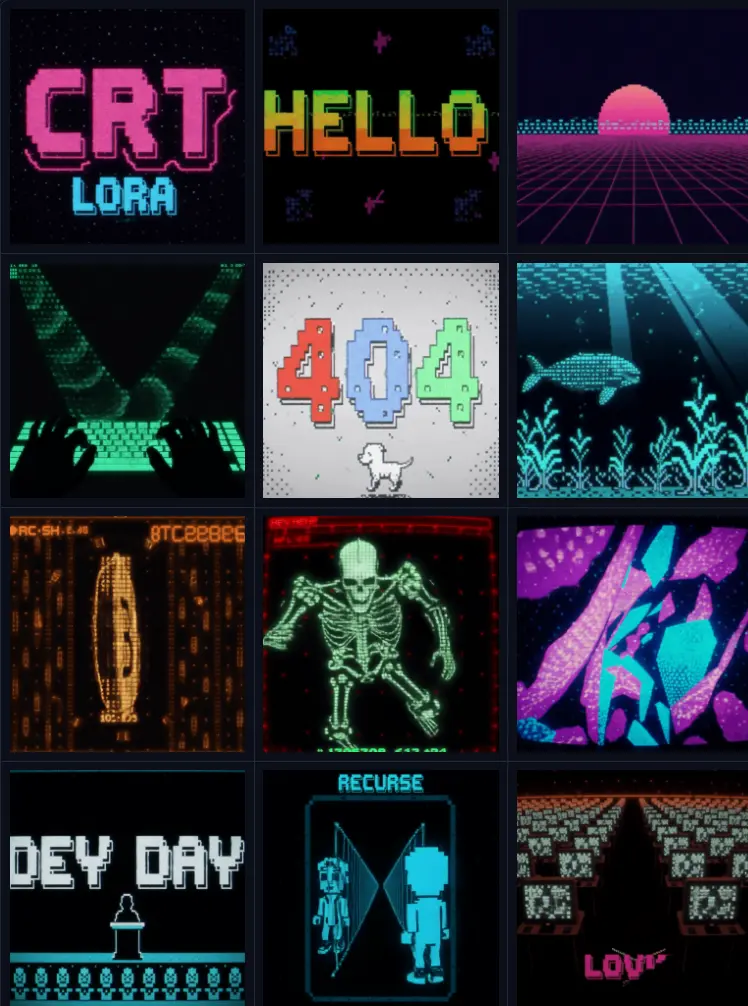
crtanim
crtanim 是一款专为 LTX-2.3 22B 视频生成模型设计的开源 LoRA。它能将生成的视频内容完美复刻 80 年代末至 90 年代初的 CRT 显示器美学,包括扫描线、磷光余辉、色差、桶形畸变、信号噪声以及特有的低帧率卡顿感。
Ltx2.3-VBVR-lora-I2V
LiconStudio 正式推出了针对 LTX-2.3 (22B) 基础模型的 VBVR LoRA 微调权重。这一更新旨在解决当前视频生成模型在复杂逻辑、物理规律和多物体交互方面的短板,通过引入 VBVR 数据集进行专项训练,显著提升了模型对因果律、空间关系和运动动态的理解与生成能力。
智能时代的产业政策:以人为核心的治理理念
OpenAI 的提案本质上是一份愿望清单,一份公开声明,帮助民选官员、投资者和公众了解这家估值 8520 亿美元的公司如何看待人工智能改变劳动力和经济的时代中世界的转变。
PixelSmile
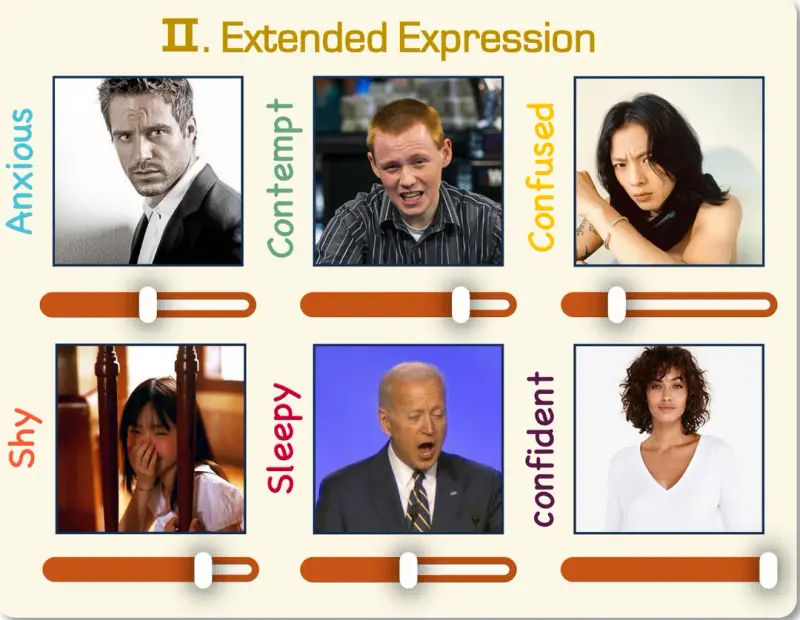
PixelSmile是一款专门针对细粒度面部表情编辑而训练的模型。你可以通过平滑的强度滑块控制 12 种表情,混合多种情绪,并且它同时适用于真实照片和动漫图像。
Flux.2 Klein 4B Consistency LoRA
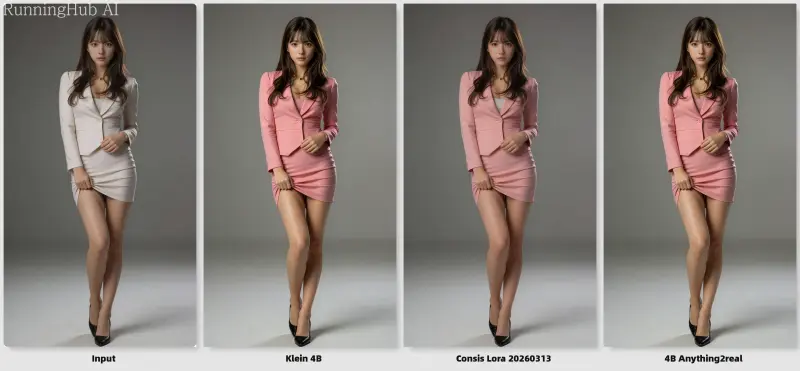
开发者 lrzjason 发布了 Flux.2 Klein 4B Consistency LoRA。这款新工具的核心目标非常明确:显著减少结构漂移,消除“AI塑料感”,并恢复自然、真实的摄影纹理与色彩。

AI的劳动力市场影响:一种新度量与初步证据
Anthropic 最新发布的研究报告《人工智能的劳动力市场影响:一种新度量与初步证据》却给出了一个冷静甚至略带反直觉的结论: 截至目前,AI 尚未开始大规模取代人类,失业潮并未发生。

QIE-2509-Object-Remover-Bbox
QIE-2509-Object-Remover-Bbox 是为 Qwen-Image-Edit-2509 开发的一个 LoRA,使用边界框引导精确地从图像中移除不需要的物体。
Z-Image-Turbo-Art
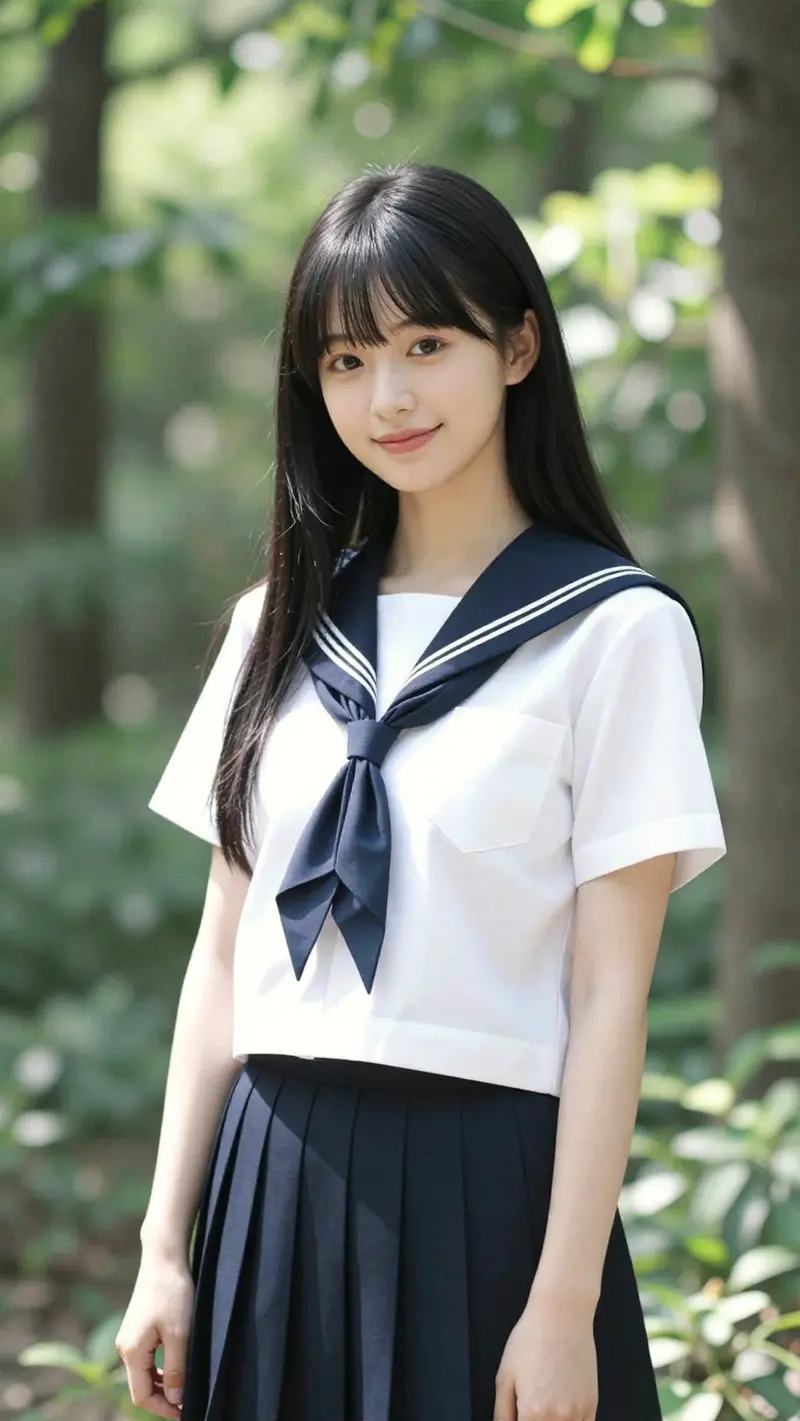
Z-Image-Turbo-Art是一款由开发者wikeeyang打造的融合微调文生图模型,核心基于Z-Image基座模型与Z-Image-Turbo分层融合后快速微调而成,是探索Z-Image基座模型风格化能力的一次实用尝试。
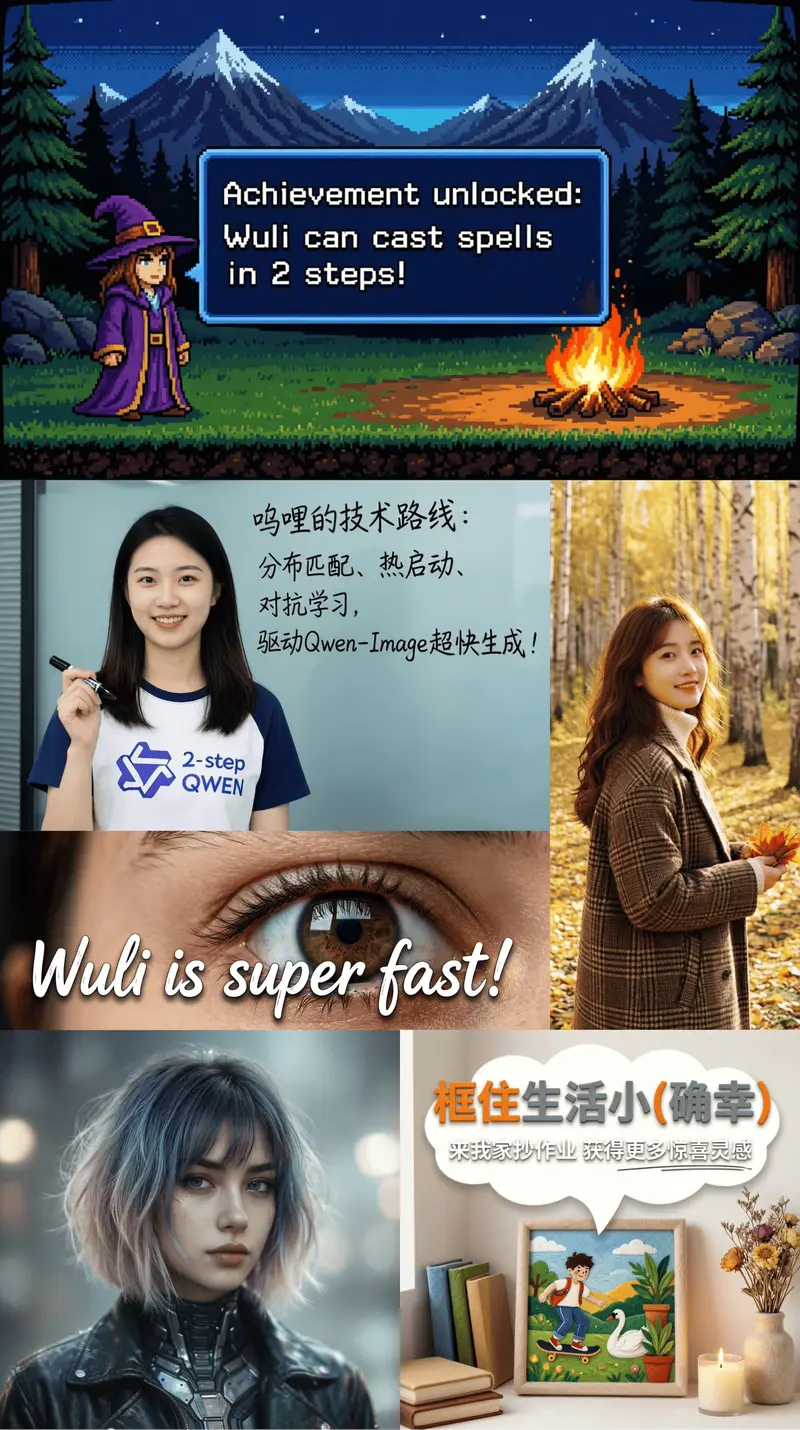
Qwen-Image-2512-Turbo-LoRA-2-Steps
由 Wuli 团队训练的 两步加速版 LoRA,适用于 Qwen Image 2512,相比Wuli 之前的 四步加速版 LoRA 有所改进。
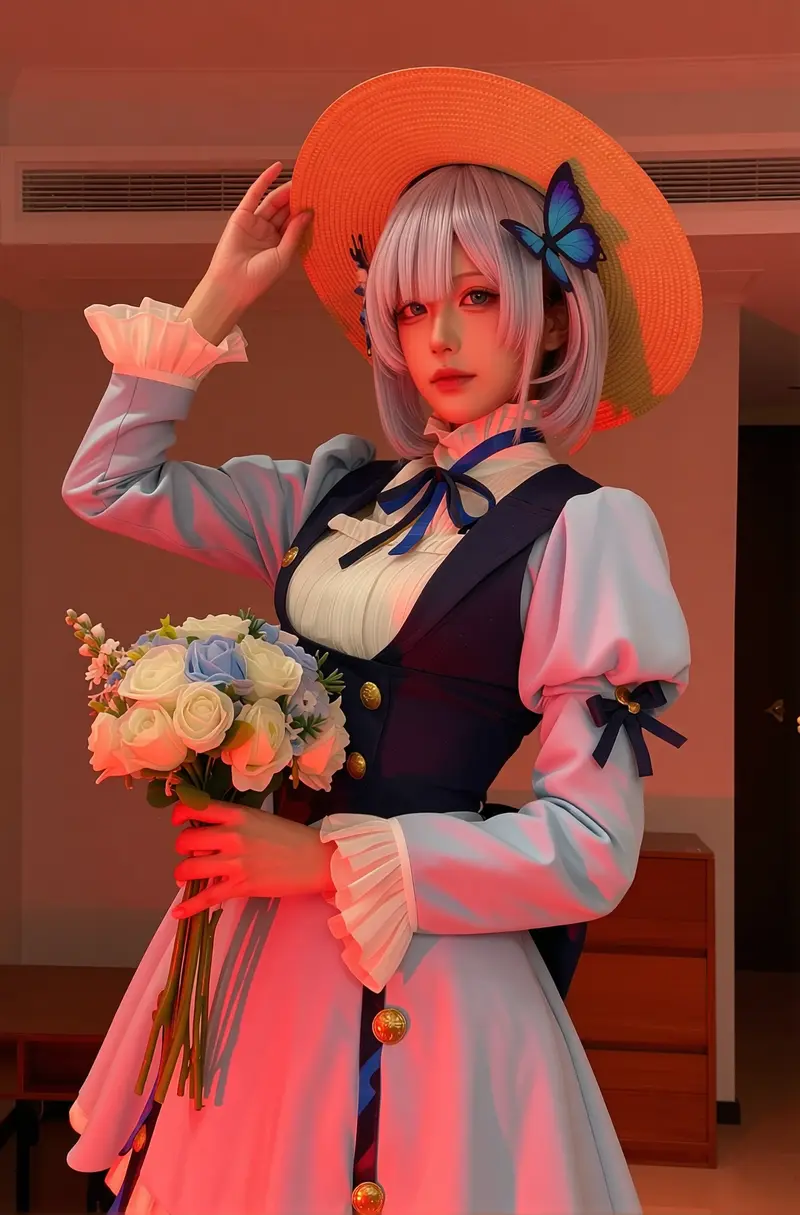
Qwen-Edit-2511_LightingRemap_Alpha0.2
基于 Qwen-Edit-2511 模型训练的 Alpha 版本 LORA,专为实现 “色块引导式图像重打光” 而设计。该 LORA 能够根据图像中特定颜色的色块位置与颜色,智能地对人物或场景进行光影重构与氛围渲染,同时自动移除色块本身,生成自然、高质感的光照效果。
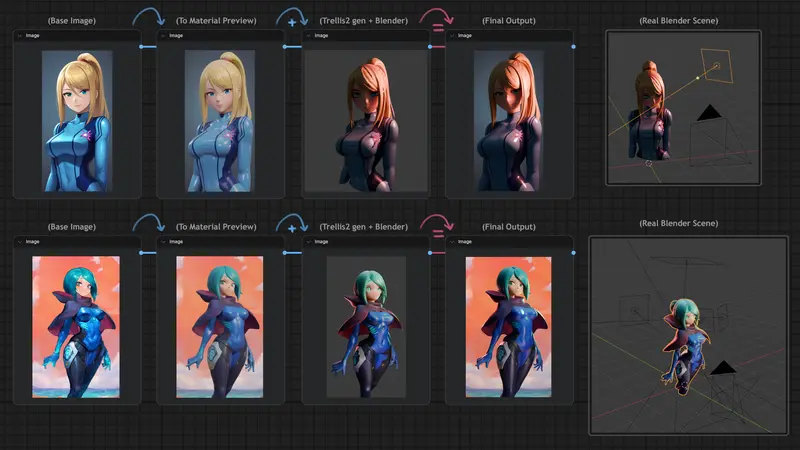
QIE-2511-MP-AnyLight
开发者lilylilith打造了 QIE-2511-MP-AnyLight这款LoRA ,旨在提供一种半实时、基于 3D 参考的光线迁移能力,让创作者能更可靠地实现预期照明效果。
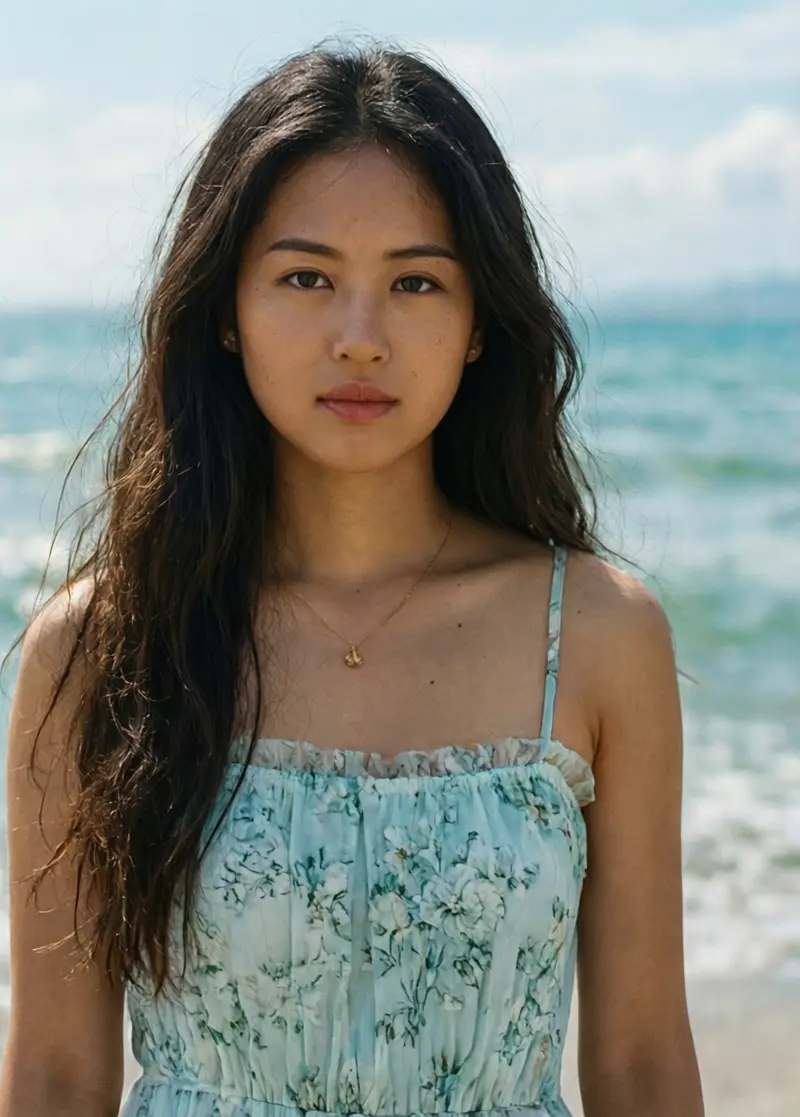
Nunchaku-Qwen-Image-EDIT-2511/Nunchaku-Qwen-Image-2512
官方 Nunchaku 推理引擎 本以高效量化著称,能显著降低显存占用,但近期对阿里新发布的 Qwen-Image-2512 和 Qwen-Image-EDIT-2511 尚未提供官方支持。 好消息是:社区开发者 QuantFunc 已率先完成量化适配,并发布了两个系列的 4-bit 模型,现已可在 ComfyUI 中直接使用。





